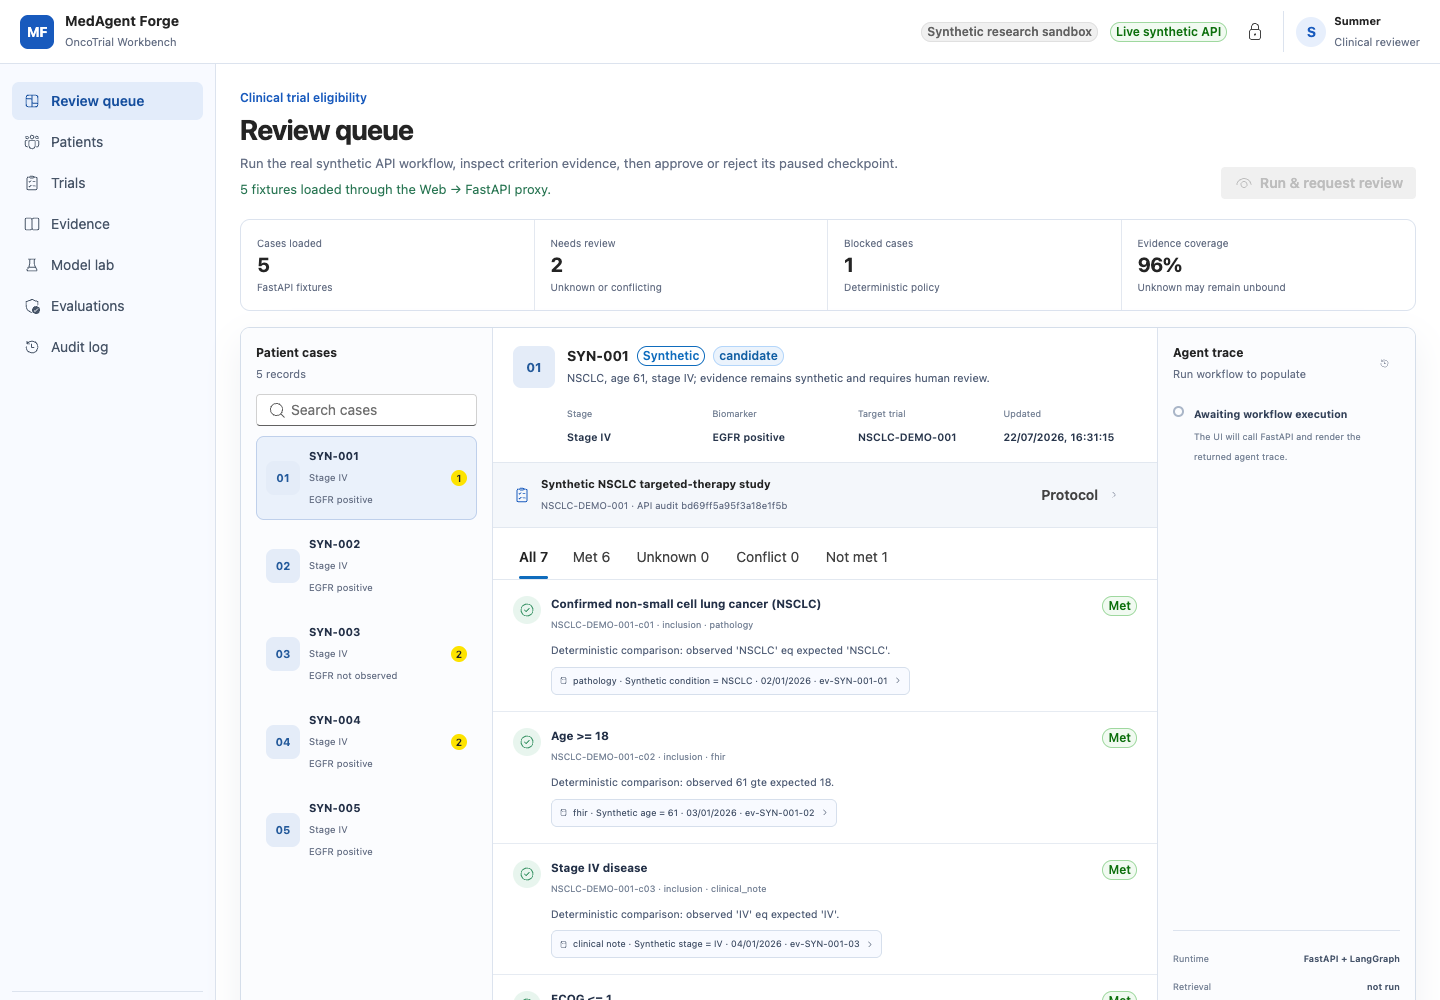
我先把一个合成病例里的 EGFR 检测删掉,再跑预筛。要是系统为了给出完整答案,把缺失补成“阴性”,界面看起来没问题,逐条结论已经错了。
第二个动作更直接:我同时放入 Stage III 和 Stage IV 两份相互冲突的记录,看流程会不会偷偷挑一条相信。它没有这样做,而是把缺失保留为 unknown,把矛盾保留为 conflict,并要求人工审核。
这就是 MedAgent Forge 的第一条规则:没有来源的判断不进入工作单,最终决定留给有资格的人。
它不是“医疗版聊天机器人”,而是一个公开、合成数据驱动的临床试验预筛工程样板。贯穿案例是非小细胞肺癌(NSCLC):系统读取教学协议和合成患者证据,逐条判断入排标准,遇到缺失或冲突就停下来。
先把边界说在前面:它不诊断、不推荐治疗、不自动入组,也不处理真实患者数据。
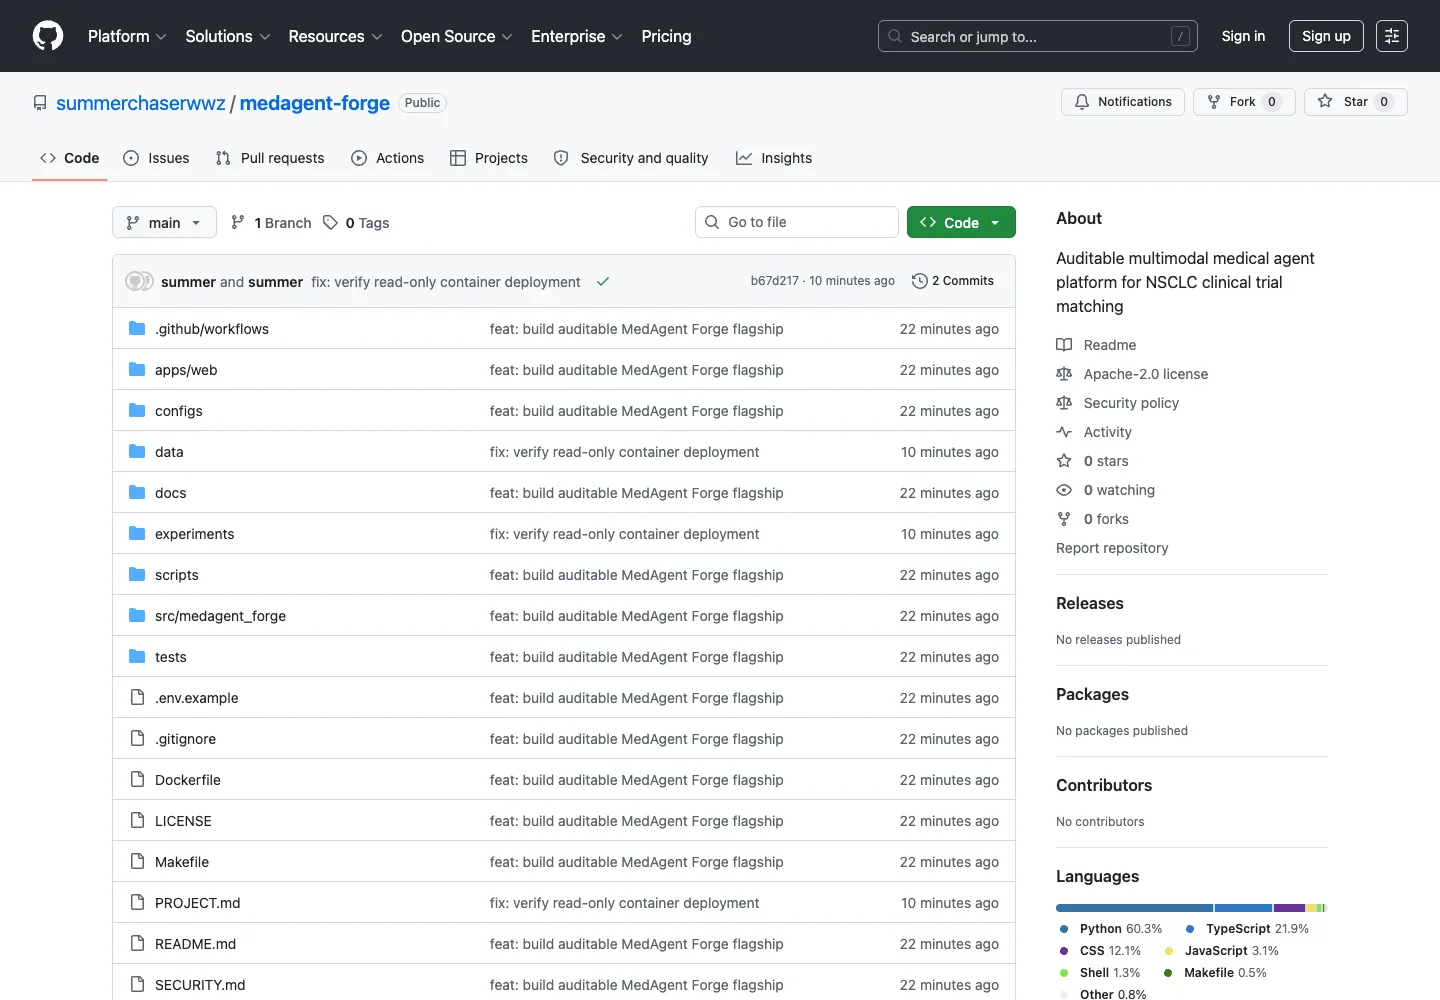
读图提示:先看仓库的工程边界,而不是把它当作临床产品展示。公开版的价值在于证据、审核和失败路径都能被检查。
一、医疗 Agent 不能只交一段“像医生的话”
普通问答系统追求“回答是否有帮助”。临床试验预筛多了几层约束。
比如协议要求“EGFR 阳性”。系统不能因为病人患有肺癌,就顺手推断 EGFR 也是阳性;没找到检测结果,只能写 unknown。如果基因报告写阳性,另一份记录却写阴性,也不能按“最新一条优先”偷偷覆盖,而要写 conflict,把两条证据一起保留。
因此,项目没有把输出定义成一段文本,而是四种明确状态:
met:现有证据支持满足标准;not_met:现有证据支持不满足标准;unknown:证据不足,不能猜;conflict:证据互相矛盾,需要人工处理。
每条判断还要带上证据 ID、来源、版本、内容哈希、局限和审核状态。语言模型可以参与解析或总结,但它不能越过这些合同。
这听起来有点“保守”。可在医疗场景里,保守不是缺陷,而是系统防止自己编故事的功能。
没有证据,就不产生确定结论。
二、先让每条判断有账可查,再谈模型能力
我把系统理解成一条证据生产线。
第一步是数据进入。FHIR 病历、临床记录、实验室、影像元数据、病理和基因报告先被转换成统一的 Evidence。这个对象不只保存“EGFR=positive”,还保存它来自哪里、何时观察、哪段原文、有哪些限制,以及原始内容的 SHA-256。
第二步是协议进入。协议解析器把自然语言入排条件转换成 TrialCriterion。解析不了的内容不会被硬塞成一个看似合理的规则,而是标记 needs_review。
第三步才是逐条判断。每个 CriterionAssessment 必须引用前面的 Evidence。没有引用的判断不能进入最终工作表。
最后是人工审核。机器状态与人工状态分开保存:系统说“候选人”不等于人工已经接受,更不等于患者可以入组。
读图提示:不要只看左侧的状态颜色。每条标准能否展开 Evidence、右侧是否留下角色轨迹和人工等待状态,才是这张工作台要证明的东西。
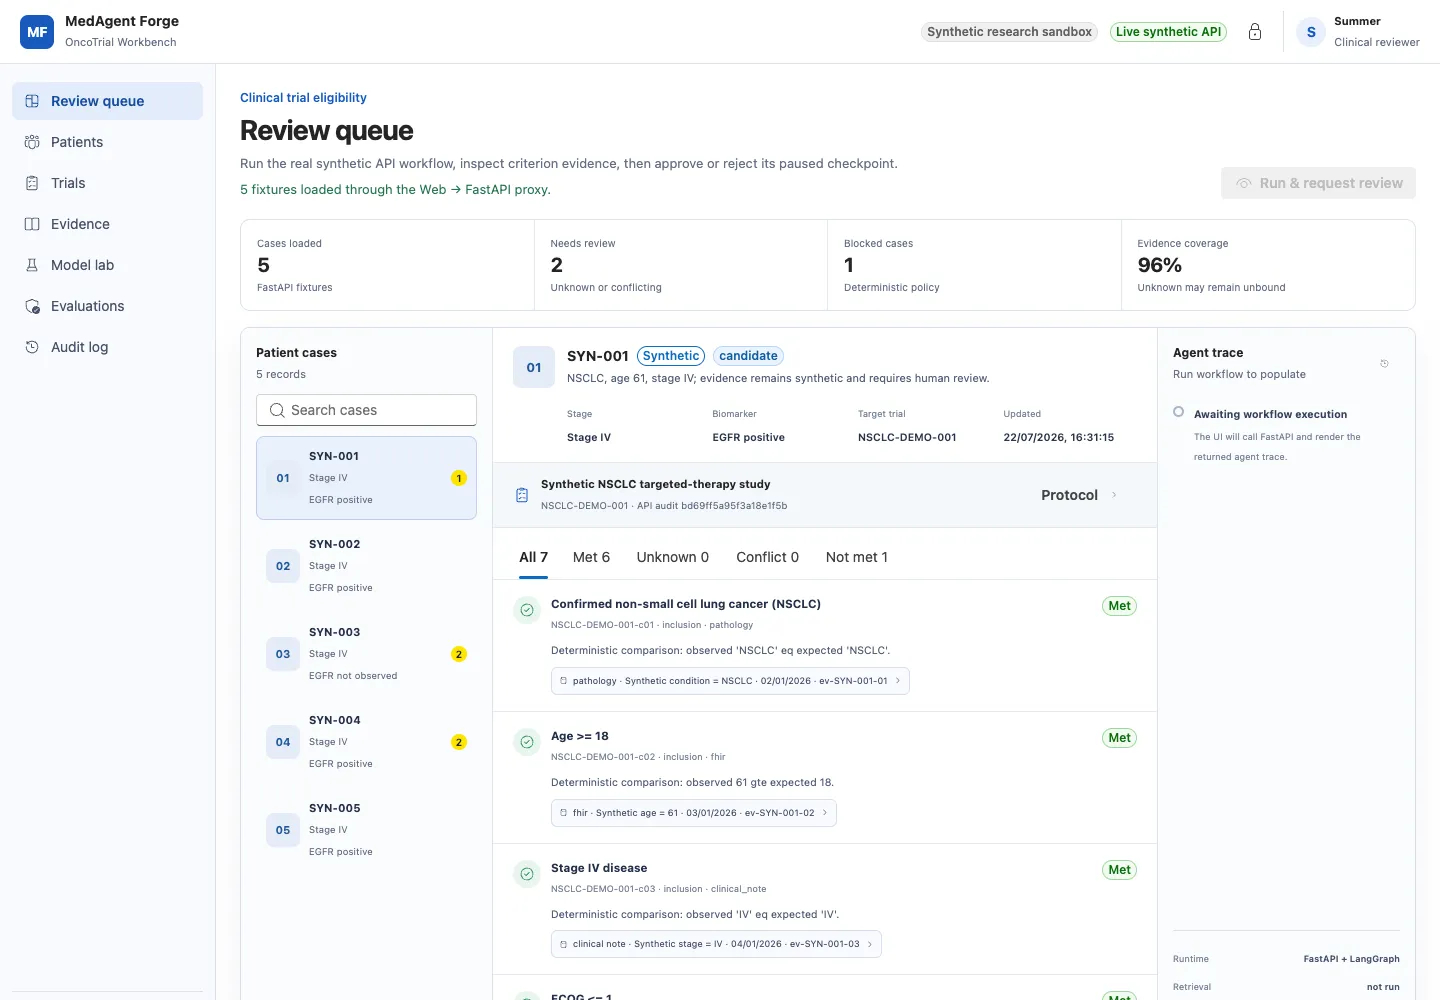
图里最重要的不是颜色,而是每条标准下面都能展开证据。右侧还保留了运行轨迹:哪个角色处理了协议、哪个角色整理了患者信息、哪里发现了冲突、人工决定是否仍在等待。
三、为什么从临床试验预筛开始,而不是做万能助手
我没有一上来做“万能医疗助手”。那样容易把几十个未解决的问题塞进一个输入框。
临床试验预筛的好处是任务边界相对清楚:有协议,有患者证据,有逐条入排标准,也有明确的人审责任。它既能覆盖医疗 Agent 的核心技术,又方便验证失败情况。
这个案例可以自然串起:
- FHIR、DICOM 元数据、病理、基因和实验室数据;
- 协议解析、试验检索、Evidence RAG;
- 模型适配与 CPT、DAPT、SFT、LoRA、QLoRA、DPO、GRPO/RLVR;
- LangGraph 多 Agent 编排、工具权限、状态与恢复;
- 执行型评测、红队、消融、Docker 和企业工作台。
但“能串起来”不等于“已经临床可用”。公开版只证明工程链路能在合成样本上按预期运行。
四、先运行完整链路,再判断项目有没有交付
当前版本可以一条命令完成合成数据生成、七组微型训练、完整测试、实验报告和前端生产构建:
python3.11 -m venv .venvsource .venv/bin/activatepython -m pip install -e '.[dev]'make verify也可以启动只读容器:
docker compose up --build系统会提供 FastAPI、与 API 真实连通的 React 工作台、五个职责隔离的 Agent 角色、人工中断与恢复、工具审批与幂等保护、十二个端到端场景,以及六组连接合成 API 录制的视频。
运行完成后,先核对端到端场景报告是否为 12/12 pass,再看缺失 EGFR 和分期冲突是否仍进入显式状态。它们不是“异常被吞掉”,而是这条工程链路必须保住的结果。
项目还保留了失败记录。例如 Docker 第一次拉取基础镜像超时,没有写成“部署成功”;重试后发现只读容器里的 Vite 临时目录不可写,又补了最小内存盘挂载,直到 API 和 Web 都返回 200。
这类记录不够“漂亮”,却比一张只展示成功结果的架构图更有价值。工程系统不是靠口号证明可靠,而是靠失败能否被发现、解释和复现。
五、这些事它明确没有做,也不能假装做了
公开仓库没有下载 MedGemma 权重,没有在 M3 Max 或 CUDA 集群上完成大模型训练,也没有接入医院系统。MLX 与多卡配置是未执行的参考配置,不能当作实验结果。
合成样本上的 12/12 通过,也不能换算成临床敏感度或特异度。真正进入研究还需要:有许可的数据、标注规范、盲评、亚组和漂移分析、权限与审计基础设施,以及医疗、伦理、法务和安全共同确认的使用边界。
Google 的 MedGemma 文档也强调,这类模型是开发者构建医疗应用的基础组件,不是可直接用于医疗工作的独立产品。模型能力很重要,但应用责任不会因此消失。
六、接下来按证据链往下读
接下来五篇,我会把项目按真实实现顺序展开:
- FHIR、多模态和合成数据工厂;
- 协议解析、检索、逐条匹配与 Evidence RAG;
- MedGemma 边界与七类后训练实验;
- LangGraph 多 Agent、工具、状态、记忆和故障恢复;
- 执行型评测、安全红队、部署与完整复盘。
所有代码都在仓库里,完整教材是 《从零构建 MedAgent Forge》。第二篇从数据入口开始,直接看 FHIR、影像、病理和基因数据怎样变成同一份 Evidence 账本。
延伸阅读
- HL7 FHIR Provenance:理解“这条事实从哪里来、被谁加工过”。
- ClinicalTrials.gov Data API:理解公开试验记录的接口边界,不把它当作患者数据源。
- Google Health AI Developer Foundations:了解医疗 AI 开发组件的官方定位,再回头检查应用层还需要承担哪些责任。