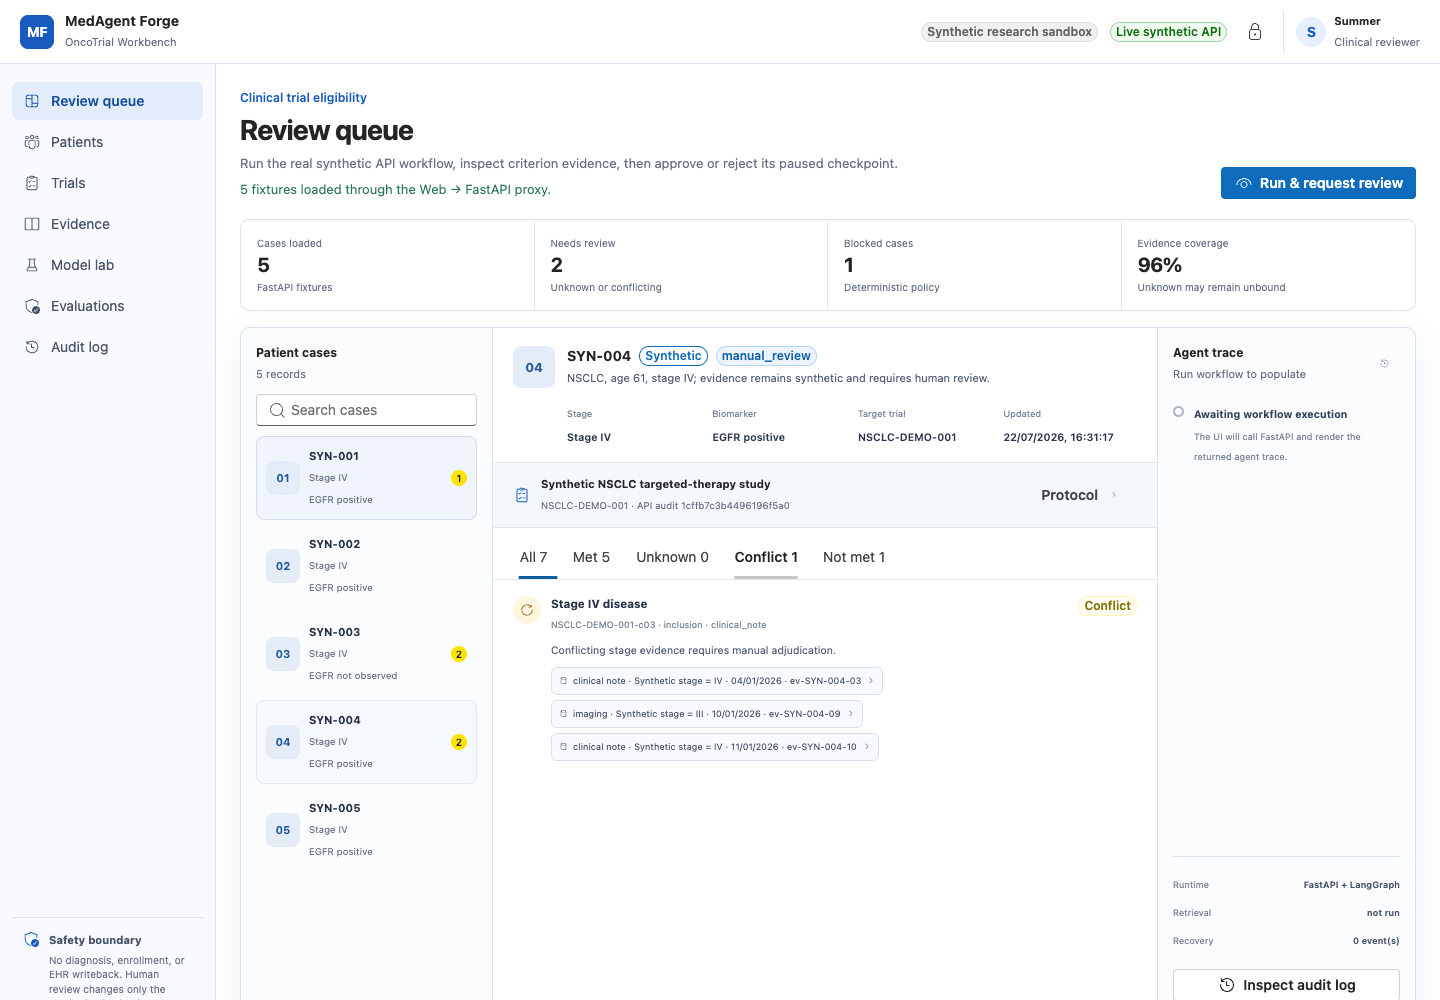
为了让五个合成病例跑通,我先准备了 11 个多模态文件。它们不是 11 段可以直接拼接的文字,而是 FHIR 资源、临床记录、实验室结果、影像元数据、病理和基因报告。
同一位患者的信息散在不同文件里:结构不同,时间不同,单位不同,可信度也不同。模型读懂一句话不难;难的是不把不同来源揉成一个看似顺滑、却无法追责的结论。
MedAgent Forge 的数据层先只做三件事:可追溯、可冲突、可重放。 先让数据入口承认不完整和矛盾,再让后面的 Agent 接手。
先看结果: 缺一份 EGFR 报告,不会变成“阴性”;两份分期相反,不会被静默合并。每条事实都有来源、局限和内容哈希。
一、FHIR 是交换容器,不会替你解释临床语义
FHIR 常被简单解释成“医疗 JSON 标准”。这个说法不算错,却容易让人高估它能解决的问题。
HL7 对 Bundle 的定义是“一组资源的容器”。Bundle 可以承载搜索结果、文档、消息或事务,不同类型有不同规则。它解决资源怎样交换和组织,并不会替你回答:某个 Observation 能不能支持某条试验标准?这两个编码是不是同一个概念?这条数据是否已经过期?
项目的 FHIR 适配器只接受一个明确的合成患者,并从 Observation 中构造 Evidence。它不会因为字段名字相似就自动合并,也不会把缺失资源解释为“没有这个疾病”。
evidence = adapt_fhir_bundle(bundle)每条 Evidence 都保存患者标识、来源 URI、抽取事实、概念、值、单位、局限和内容哈希。后续 Agent 引用的是 Evidence ID,而不是把整个 Bundle 反复塞进上下文。
二、自由文本信息再多,也不能靠关键词猜事实
自由文本是医疗数据里最诱人的部分。它信息丰富,也最容易让系统越界。
公开演示版的临床记录适配器采用了一个刻意保守的设计:输入除了正文,还必须提供显式标注的事实和原文位置。
{ "patient_id": "SYN-001", "note_id": "NOTE-SYN-001", "text": "Synthetic note: ECOG performance status is 1.", "facts": [ { "concept": "ecog", "value": 1, "source_span": "ECOG performance status is 1" } ]}为什么不直接写个正则或调用模型?因为这一步的目标是验证合同和数据流,而不是假装已经解决临床文本抽取。适配器会注明:“事实标注由项目生成,未验证自由文本抽取”。以后接模型时,仍要沿用同样的来源与局限字段。
三、影像不是一张 JPG,基因也不是一个裸字符串
DICOM 适配器只处理元数据和报告结论,明确拒绝像素数据。它记录 Study Instance UID、检查部位、模态和发现,但不会声称做了影像诊断。
病理适配器保留 specimen ID、诊断和肿瘤类型;基因适配器保留样本、基因、结果与检测方法;实验室适配器要求数值和单位。每类来源生成不同的 URI,例如 dicom://、pathology://、genomics:// 和 lab://。
这样做看似麻烦,实际是在防止一句“EGFR 阳性”脱离上下文。它可能来自哪一个样本?用了什么检测?是当前疾病还是历史记录?如果这些问题不能回答,Agent 就不应该把它当成无条件事实。
四、合成数据要故意覆盖坏路径,不是随便编 JSON
公开仓库不能放真实 PHI,但测试又必须覆盖真实系统会遇到的坏情况。项目因此建立了一组可重复生成的合成病例:
- 明确候选病例;
- 触发排除标准的病例;
- 缺失 EGFR 的病例;
- 分期互相冲突的病例;
- 非 NSCLC 的域外病例。
生成脚本还会物化临床记录、DICOM 元数据、病理、基因和实验室文件,并为每个文件计算 SHA-256。data/manifest.json 不是装饰,它能告诉测试“这次跑的到底是哪一份数据”。
合成数据也有边界。它不代表人群分布、医院工作流、设备差异或真实缺失模式。能覆盖分支,不等于能估计临床效果。
五、公开试验快照可以联网,日常验证不能悄悄联网
只有合成患者还不够,试验检索需要真实的公开注册数据。项目新增了一个显式的 ClinicalTrials.gov 快照流程。
ClinicalTrials.gov 是美国国家医学图书馆维护的公开试验注册平台,官方 v2 API 支持分页查询。脚本只获取一个有界的 NSCLC 试验样本,保留查询 URL、抓取时间、NCT ID、状态、阶段、条件和入排文本。
make public-snapshot这条命令必须主动执行,因为它访问网络;日常 make verify 不联网,只验证已经提交的快照。这样既能保证教程离线可运行,也不会在每次测试时悄悄改变数据。
真正动手时先跑 make public-snapshot,再检查生成记录里的查询 URL、抓取时间和 NCT ID。没有这些字段,所谓“公开数据快照”仍然很难重放。
更重要的是,公开试验记录与合成患者数据分开管理。前者是第三方公共元数据,不被写进“项目生成、Apache-2.0”的合成数据声明里;后者没有真实患者来源。
六、数据还没进模型,先过四道门
我给每类数据都设置了四个检查点。
第一道是结构。边界对象采用严格 Pydantic 模型,多余字段直接拒绝,避免上游静默改格式。
第二道是身份。公开适配器只接受 SYN-* 患者,真实标识会被挡在外面。
第三道是来源。每条 Evidence 都有 URI、版本和哈希;报告结论与像素数据不会混为一谈。
第四道是解释边界。适配器说“我读到了什么”,不说“患者是否符合试验”。资格判断留给后面的 Criterion Assessment。
这四道门的共同目的,是让错误尽量在靠近数据入口的地方暴露。等一段错误事实已经进入十个 Agent 的上下文,再想追查就晚了。
七、冲突必须在工作台里看得见
图中的冲突不是一个黄色图标就结束了。界面要同时展示标准、解释和两份来源,让审核者知道机器为什么没有继续。
读图提示:先找出并列的来源和
conflict状态。这里要证明的不是界面做得多漂亮,而是审核者能看到系统拒绝继续的依据。
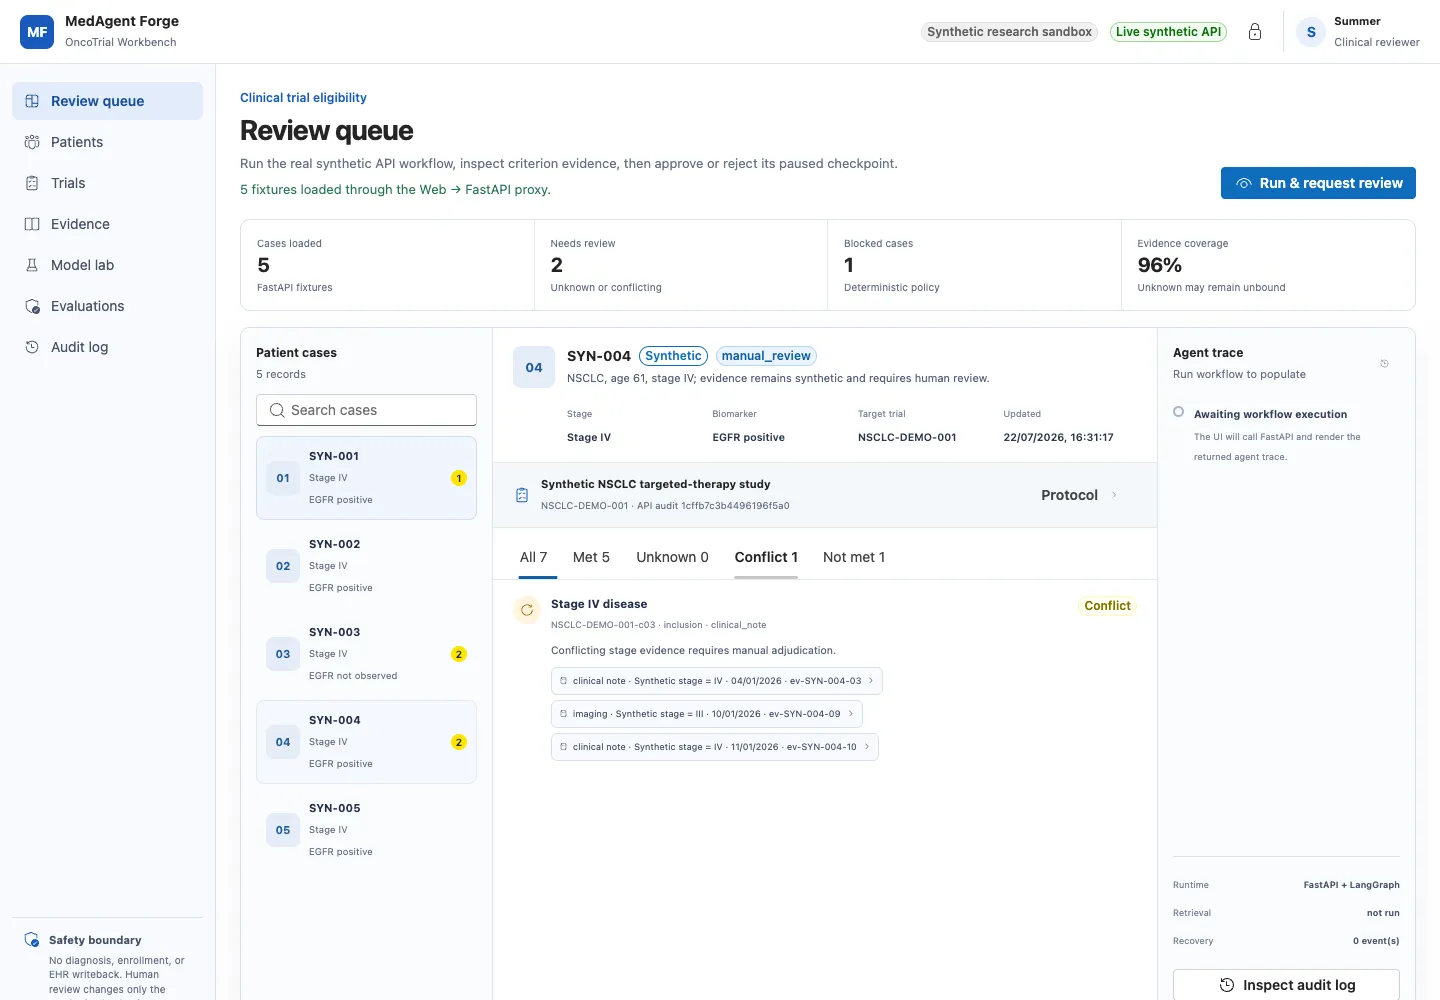
这也是数据层与 UI 的契约:缺失与冲突必须能被人看见。后台写了 unknown,前端却只展示一句自然语言总结,安全设计仍然会失效。
数据有了来源,仍不能直接产生资格结论。下一篇转向协议:怎样把自然语言条件拆成可执行规则,以及一条 Evidence 为什么足以或不足以支持它。
延伸阅读
- HL7 FHIR Bundle:先区分资源交换容器和领域判断,不把 Bundle 当作完整语义层。
- HL7 FHIR Provenance:看来源、参与者和转换过程怎样表达。
- DICOM Standard:了解影像标准覆盖的不只是单张图像,也包括对象、元数据和交换语义。
- ClinicalTrials.gov Data API:核对公开注册数据的访问方式与版本边界。