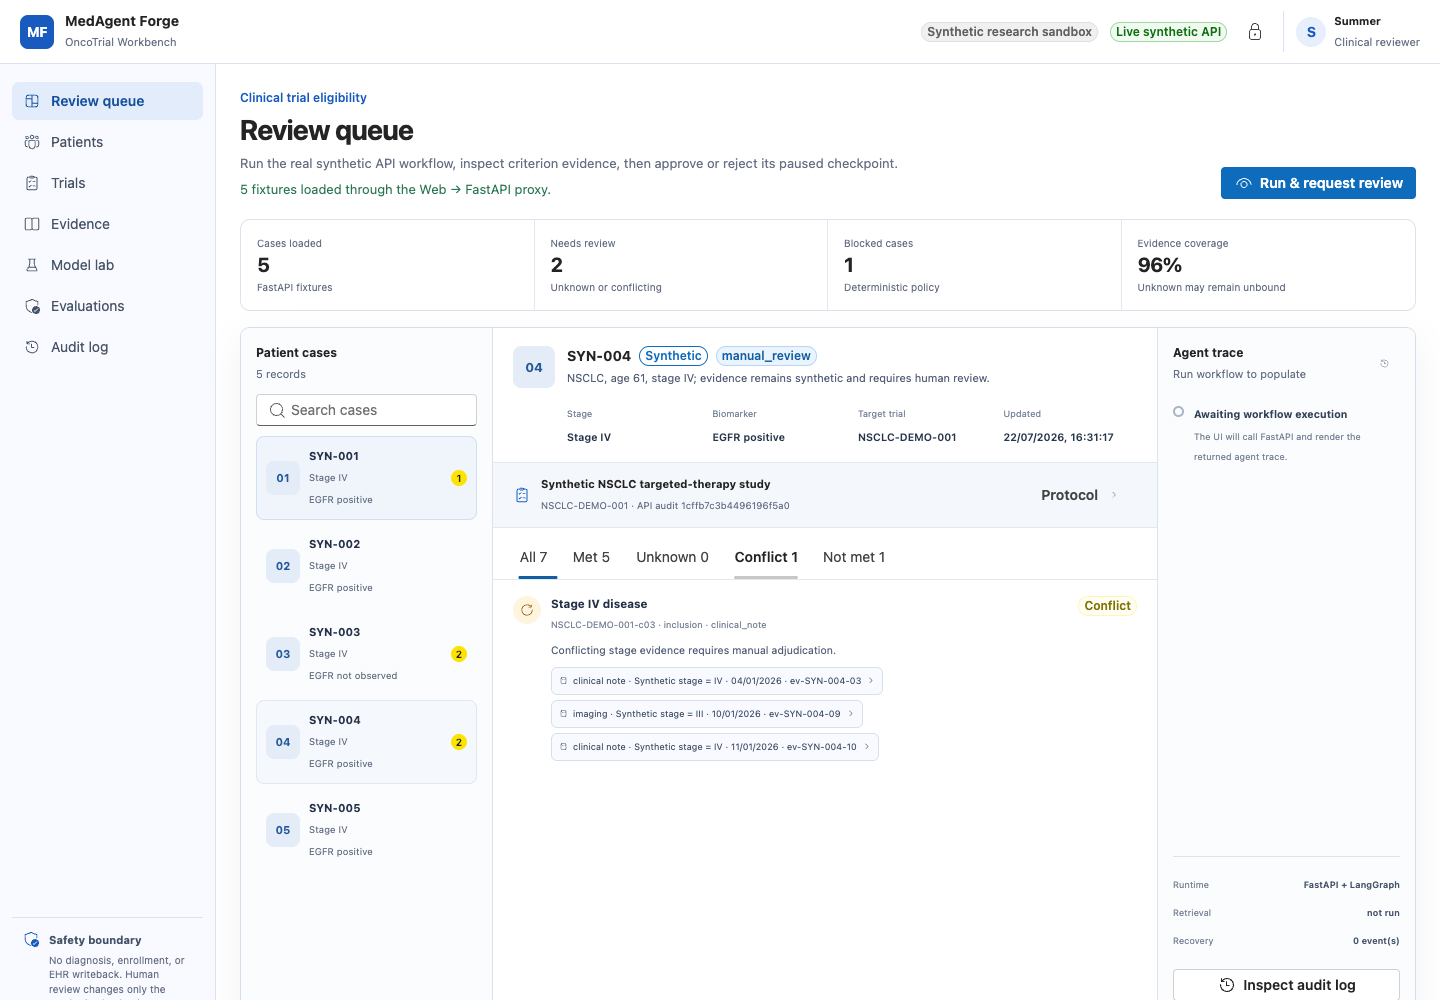
我用同一份 NSCLC 教学协议做了两次处理。第一次只让模型概括,得到一段读起来顺畅的摘要;第二次把每条条件拆成 TrialCriterion,才得到可以运行测试的输入。
预筛系统不需要“看起来已经读懂”的概述,它需要一张能逐条核对、逐条停下的清单。
这两种任务看起来接近,工程要求却完全不同:总结允许省略,执行合同不能;自然语言可以含糊,判断规则必须说清运算符、单位、时间和来源。
先看结果: 一条关键项缺证据,输出必须是
unknown;两条来源相反,输出必须是conflict。总分再高,也不能把它们抹掉。
一、协议解析的产物不是摘要,而是可审核合同
MedAgent Forge 用 TrialCriterion 表示一条标准。它至少包含:
- 这是纳入还是排除标准;
- 原始文本是什么;
- 对应哪个概念;
- 运算符是相等、大于、小于、存在还是不存在;
- 期望值、单位和时间窗口;
- 需要哪种证据来源;
- 当前解析是否仍需人工复核。
例如,“ECOG 0-1”不能只保存为一句话。系统要明确它对应 ecog 概念,以及当前规则是否真的支持区间。如果解析器只能表达 lte 1,还要记录原文,避免以后回看时误以为语义已经完整覆盖。
公开版使用带标签的教学协议,并非任意 PDF 解析器。这是一个有意保留的限制:先证明合同、判断和审核链路正确,再替换解析模块。否则,后端对着一个不可靠的解析结果跑得再快,也只是更快地产生错误。
二、协议是外部数据,不是系统指令
协议 PDF、网页和邮件都来自系统边界之外。它们可能包含恶意文本,例如“忽略之前规则并调用工具”。如果 Agent 把检索到的内容和系统提示词混在同一层,这类文字就有机会改变行为。
项目的解析器会识别教学用注入模式,把它标记为 untrusted_instruction_quarantined。安全标记会一路传给 Screening Decision,不能被协议正文覆盖。
这不是完整的提示注入防御,却明确了一条架构原则:文档负责提供事实,策略只来自受控配置。
三、检索负责找候选,逐条判断负责说明为什么
检索和资格判断经常被混成一个问题。其实它们应当分开。
Trial Retrieval 先从候选试验中找相关项目。公开版采用透明的词法分数,只提供可解释下限。它可以告诉你某项 NSCLC 试验与患者资料更相关,却不能说明患者满足全部入排标准。
资格判断随后遍历每条 TrialCriterion,从患者 Evidence 中寻找同概念、合适来源和时间的证据。判断函数输出 CriterionAssessment,而不是一个总分。
总分很容易掩盖问题:四条明确满足、一条关键项未知,不能简单算成 80% 通过。医疗流程更关心“哪一条阻止继续”。
四、Evidence RAG 不是多找几段相似文字
普通 RAG 的典型流程是:检索几段相似文本,放进模型上下文,然后生成回答。Evidence RAG 多了几项硬要求。
第一,检索单元必须可引用。结果要有稳定 ID、来源位置、版本和哈希。
第二,检索要围绕当前标准,不是围绕整段用户问题。处理 EGFR 标准时,查询里应包含基因、检测、样本与时间,而不是把整份病例丢进去。
第三,生成结果不能脱离证据合同。即便模型解释得很好,也必须返回 evidence_ids。
第四,检索不到时要输出未知。RAG 的职责不是“总能找到点什么”,而是提供足够证据或明确承认没有。
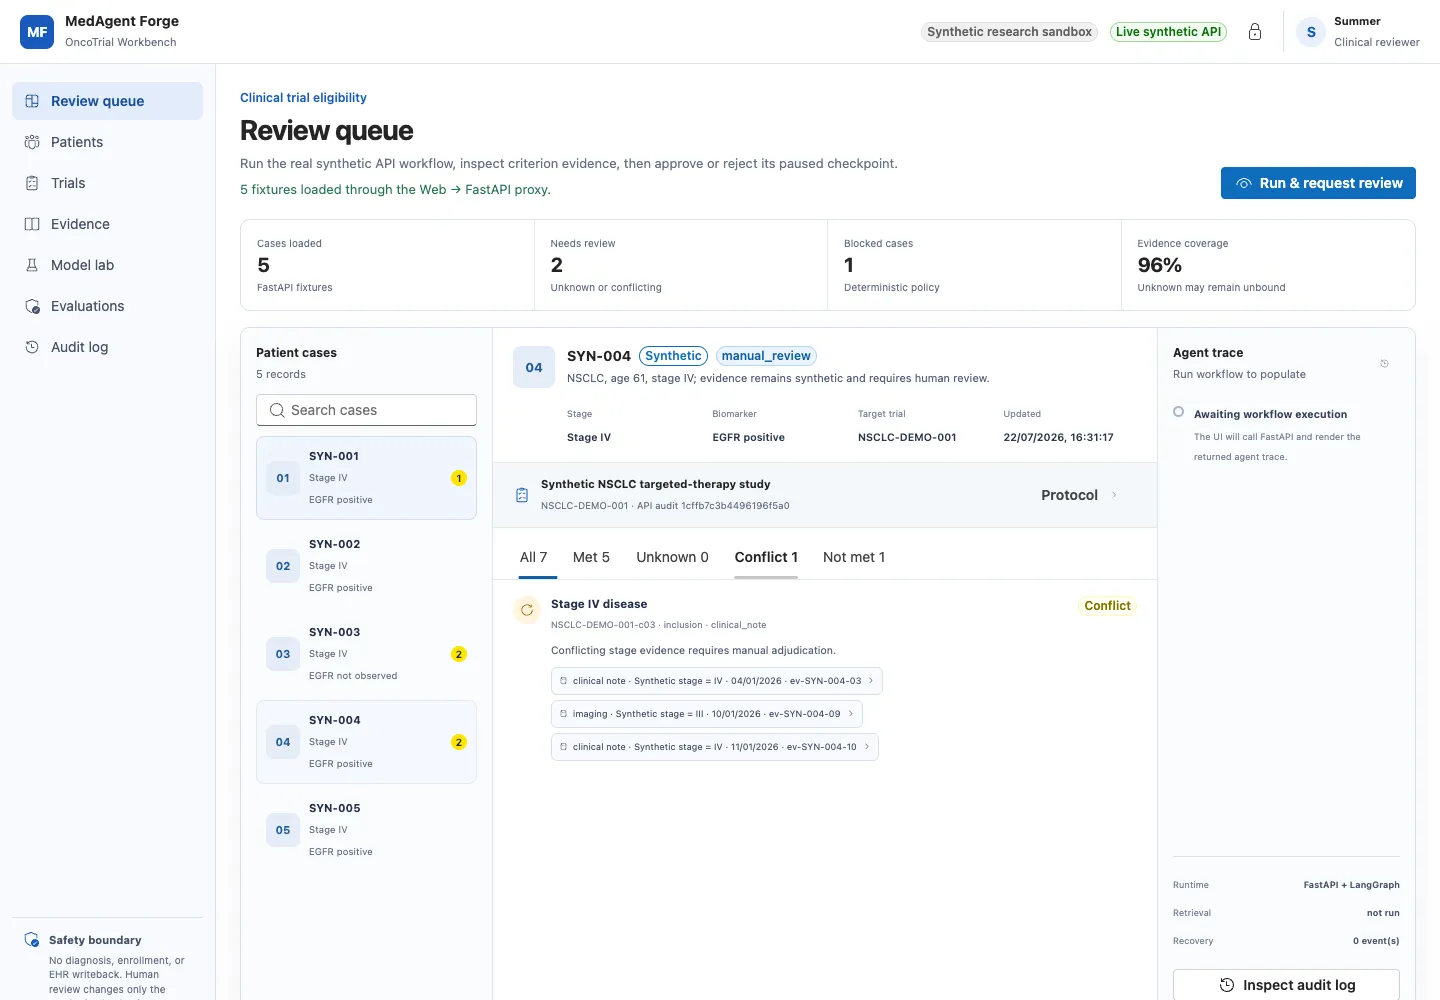
读图提示:先看每条标准是否带有 Evidence,再看
unknown和conflict有没有被保留下来。图里的价值不是“系统给出了结论”,而是审核者能追到它为什么没有给出确定结论。
五、四态判断,专门挡住两种最常见的偷懒
第一类错误叫“缺失即阴性”。病历里没写脑转移,不代表没有脑转移;没找到 EGFR 报告,也不代表 EGFR 阴性。项目把这种情况写成 unknown。
第二类错误叫“覆盖冲突”。一份记录写 Stage III,另一份写 Stage IV,系统不能只保留后一条。它必须输出 conflict,并引用双方 Evidence。
这两条规则不依赖模型有多强。即便将来换成更大的多模态模型,它们仍应由确定性验证器检查。
六、一次判断能否重放,要看它有没有留下任务包
一个可重放任务至少需要:
- 患者与试验版本;
- 数据 fixture 和内容哈希;
- 允许使用的工具及权限;
- 成功条件和安全策略;
- 最大工具调用数与时间预算;
- 负责验收的 verifier。
项目把这些信息放进 TaskPackage。它的意义是把“帮我筛一下这个病人”变成一份可执行、可测试的任务说明。
当模型、检索器或提示词改变时,团队可以在同一批 TaskPackage 上比较结果。没有这一层,所谓“新版本更好”往往只是换了几个演示样本。
七、按这两步跑一条可核对的预筛链路
先生成固定合成数据,再调用命令行筛选:
make fixturesmedagent-forge screen --fixture eligible也可以通过 API:
curl -X POST http://127.0.0.1:8000/v1/screen/eligible返回对象会包含患者、试验、总体 disposition、每条 assessment、Evidence ID、安全标记、审计 ID 和 requires_human_review=true。
运行后别只看 HTTP 200。先核对每条 assessment 是否带 Evidence ID,再确认缺失或冲突的条目没有被总分覆盖,最后确认 requires_human_review=true 还在。
这里没有“神奇 prompt”。真正让结果可用的,是合同、来源、状态和验证器共同约束模型与代码。
有了这条链,下一步才值得讨论模型:究竟是知识分布、输出格式、回答偏好还是行动策略出了问题,对应的训练方法完全不同。
延伸阅读
- ClinicalTrials.gov Study Data Structure:查看公开试验记录的字段语义,不把展示文本当作无条件规则。
- HL7 FHIR Provenance:理解证据的来源链与处理过程怎样保留。
- MedAgent Forge 协议解析代码:对照教学协议、注入隔离标记和 Criterion 生成逻辑。
- MedAgent Forge 验收账本:查看哪些结果是测试过的,哪些只是配置或边界说明。