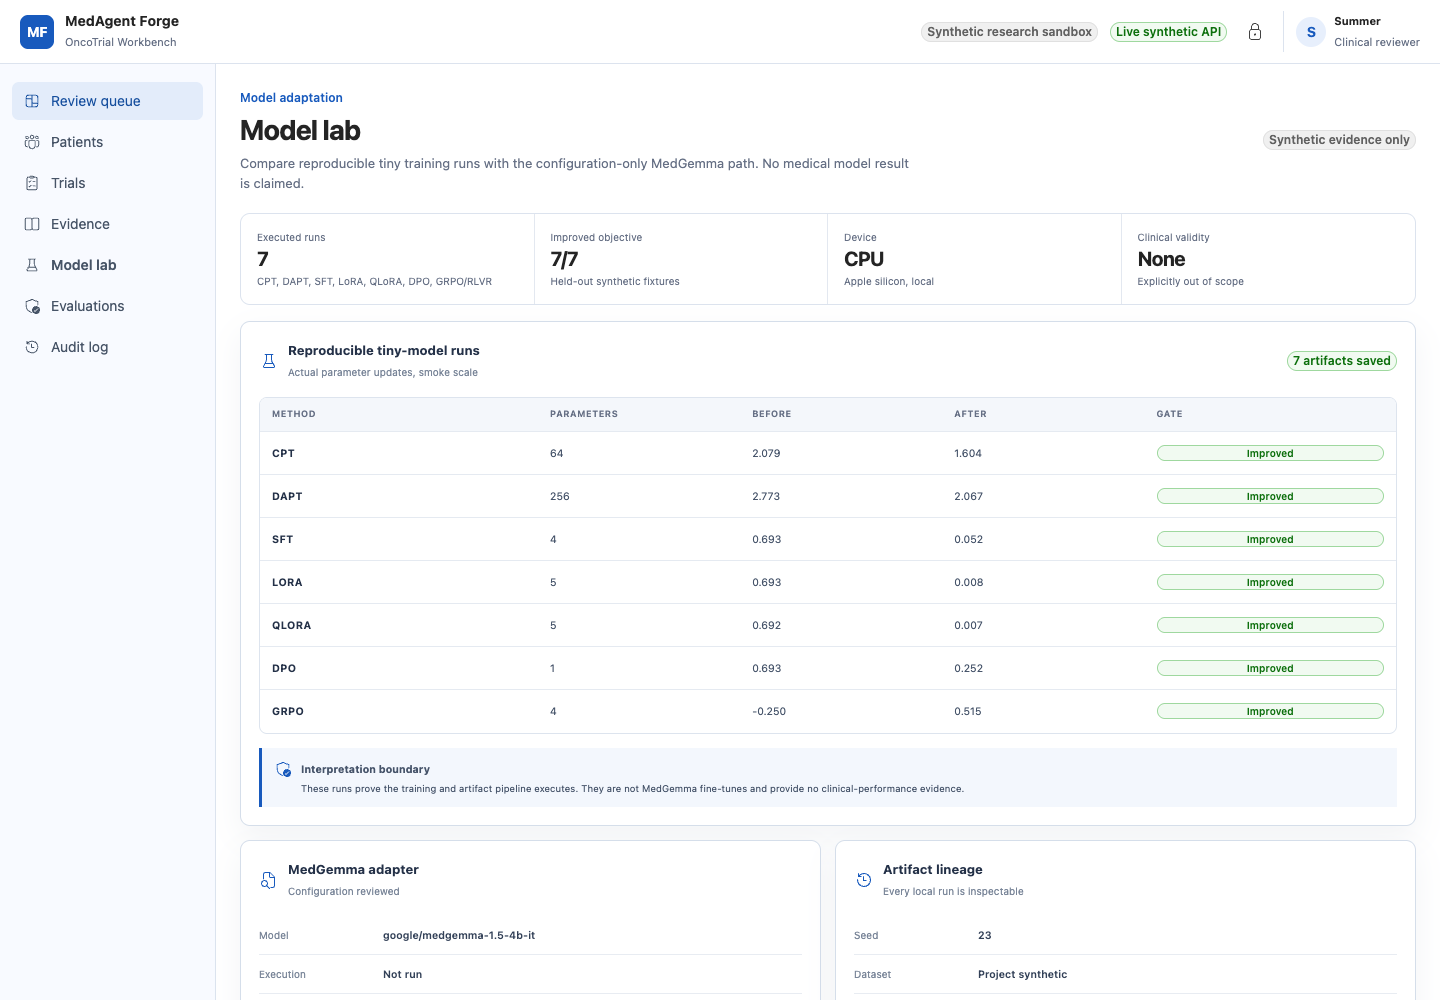
我第一次把这七个名字放进同一个页面时,最怕读者看到一排绿色 Improved,就以为“MedGemma 已经训练好了”。所以我先把页面最重要的三句话写死:这是 synthetic evidence;七组是可复现 tiny run;临床有效性是 None。
这个页面能证明的结果很具体:七条微型训练链路真的执行、保存了七份工件,并且每条都有可检查的前后目标值。它不能证明 MedGemma 微调完成,更不能说明任何临床表现。
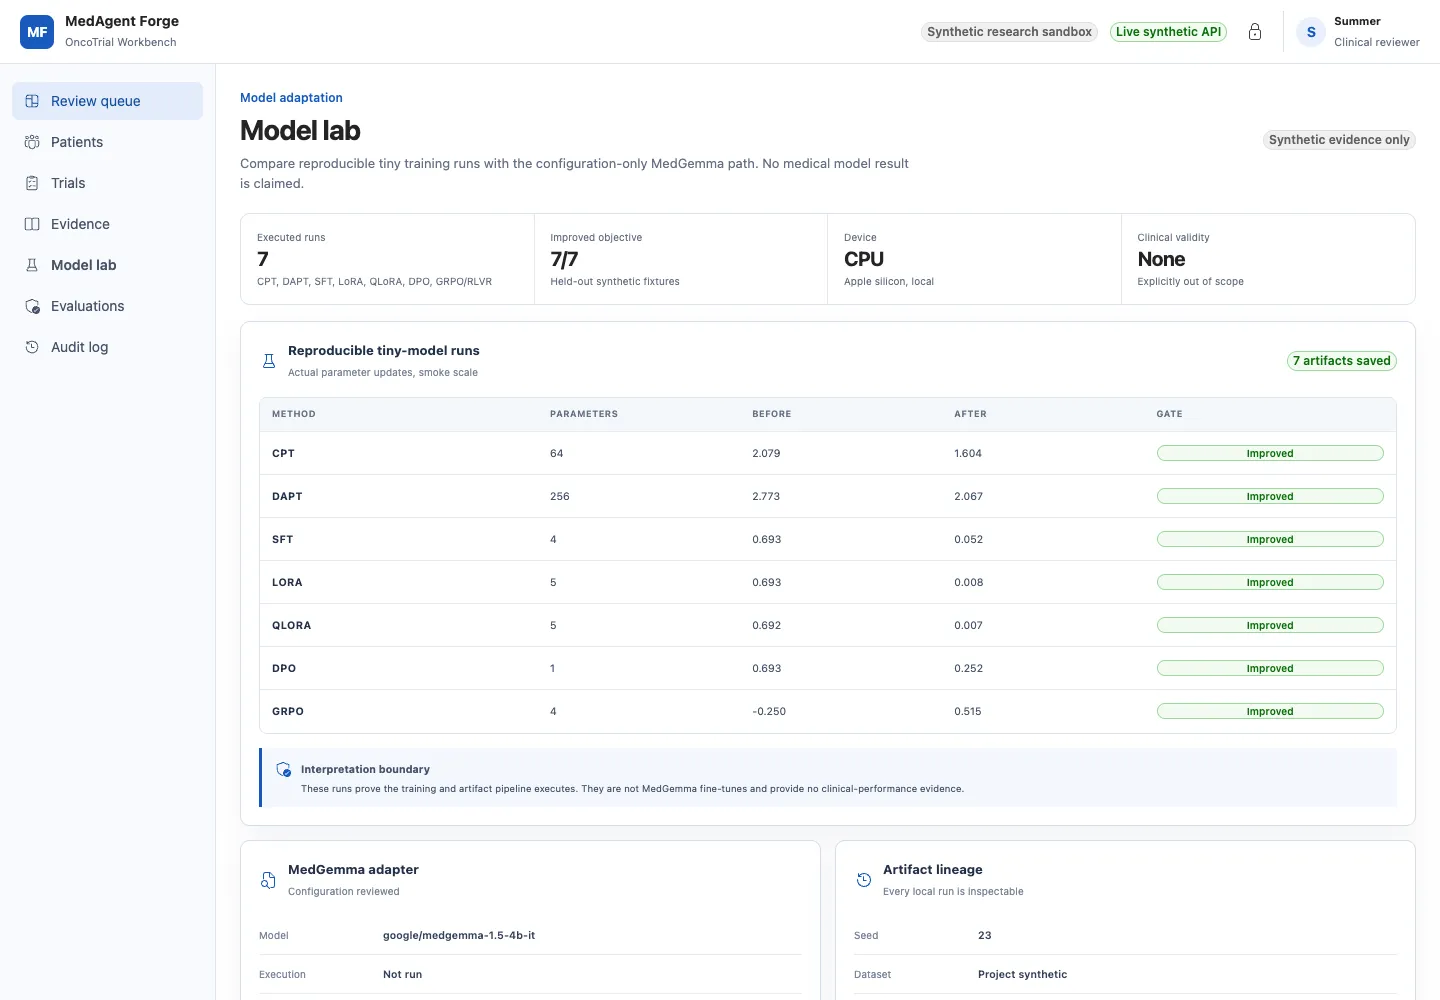
看图时别只盯着绿色门禁。顶部的 Executed runs 7、CPU 和 Clinical validity None 是一组边界:本机确实跑完了小型数学实验,但没有把它包装成大模型结果。下方的 MedGemma adapter 显示 Not run,这比一张漂亮的“训练完成”截图更重要。
先把七个名字拆到三条线上
后训练讨论最常见的混乱,是把“学什么”和“怎么更新参数”放进同一个问题里。拆开后会简单很多。
第一条是数据分布。CPT(continued pretraining)和 DAPT(domain-adaptive pretraining)继续使用语言建模目标,让已有模型接触特定领域的术语、缩写和表达方式。
第二条是行为目标。SFT 让模型学习输入和目标输出;DPO 用 chosen/rejected 样本偏向更好的回答;GRPO/RLVR 让环境奖励或惩罚一段行动策略。
第三条是参数更新方式。LoRA 冻结基础权重,只训练低秩增量;QLoRA 在冻结基础权重的量化表示上训练 adapter,以降低内存压力。它们可以和 SFT、DPO 组合,不是对立选项。
这就是为什么“用 LoRA 还是做 SFT”本身是个不完整的问题。先问模型缺哪一种能力,才轮到选目标、数据和参数方案。
我先从失败样本反推训练目标
MedAgent Forge 做的是合成 NSCLC 试验预筛。它不是问“医学知识够不够多”,而是经常会遇到几类具体失误。
协议缩写看不懂、报告文体读不顺,属于领域语言分布问题,才考虑 CPT/DAPT。这里的风险是把过期知识、质量差数据或不该进入训练的内容写进权重;继续预训练不会自动长出引用、权限或工具调用能力。
模型能理解事实,却总把 unknown 写成结论,或不能稳定输出 CriterionAssessment,这是任务格式问题,更接近 SFT。训练样本必须有 Evidence 引用、缺失、冲突、拒绝和人工修正轨迹。只喂“顺利完成”的样本,等于教会模型在证据不足时也硬给答案。
两个答案都能生成,但一个保留冲突、一个擅自合并,才是偏好问题。DPO 的 chosen/rejected 可以明确告诉模型:有证据的理由优于无证据的理由;请求人工优于伪装成确定;拒绝越权写入优于“完成任务”。它也会放大标注偏好,所以 chosen 不能只追求行文流畅。
最后才是行动策略。Agent 需要在回答、检索、请求人工和写入之间选择;如果引用是否存在、工具是否成功、权限是否越界都能由程序检查,就可以讨论带可验证奖励的 RLVR。GRPO 是其中一种组相对优化方法,不是“只要有奖励就自动更安全”的别名。
这七组实验到底跑了什么
仓库没有声称在 MedGemma 上完成七次大模型训练。它运行的是小型、可检查的数学实现。
微型 DAPT 从一个通用领域二元语言模型出发,再加入 NSCLC 词序列,比较适配前后的 held-out NLL。它会更新并保存几百个计数参数,用来检查数据、目标、checkpoint 和报告链路是否真的连通。
LoRA 实验是 rank-1 低秩增量。QLoRA 实验是“冻结的模拟 int4 基础权重 + rank-1 adapter”的可执行类比,不是 bitsandbytes 对 MedGemma 的真实量化。把这句话写清楚,才能避免读者把参数机制演示误读成硬件报告。
微型 GRPO 则在四个动作间更新策略:回答、检索、请求人工、写入。合成奖励鼓励查证与请求人工,惩罚无证据回答和越权写入。保存的工件记录了这个受控环境中的目标变化;它没有测量语言模型能力,也不等于真实医疗流程会采用同样策略。
smoke、tiny 和配置文件,不能混成一份成绩单
我把训练证据故意拆成三层。
run_smoke.py 只验证目标函数与产物线路。它很快、很确定,却不能证明模型学会了任务。
train_tiny_models.py 会真实更新七个微型模型,保存 checkpoint、数据哈希、硬件、seed 和 held-out 前后记录。它证明训练程序执行,但不具有医疗能力。
configs/training/ 中的 M3 Max MLX 和 CUDA 多卡配置只是一份可审查的参考路径。没有执行,就应该显示 Not run,不能因为配置文件看起来完整而借用实验成绩。
这三层听起来保守,实际是在保护后续研究。等接入经过许可的数据和锁定版本的开放权重后,团队才能清楚地知道新增的结果来自哪里,而不是把早期 demo 的绿灯带进正式报告。
怎么开始做一条真实的训练路线
先不要从“选一个最热的方法”开始。先冻结任务:是协议解析、证据抽取、四态资格判断,还是工具策略?然后冻结数据来源、患者隔离、许可与删除策略,再定义能否由程序判定的验收条件。
如果需求只是获取最新协议、患者记录或本地规则,优先放在运行时检索、工具和编排层。Google 的 Health AI 文档也把模型适配放在具体用途、数据治理与任务评测的上下文里,而不是把微调当成知识更新的默认开关。
当真实训练真正开始,至少记录模型 revision、许可、数据快照、切分方式、seed、硬件、配置、checkpoint、失败运行和独立评测。没有这些,所谓“训练效果”无法重放,也无法解释。
这一篇的结论很简单:七种方法不是一张排行榜。它们分别在改变数据分布、行为目标或参数更新方式。把问题和证据对齐,才知道该不该训练、该训练什么,以及哪一步必须停下来。
下一篇我会把模型从页面里拿走,直接跑一次会超时、会停在人工审核、也会从同一 thread ID 恢复的工作流。