我不把多 Agent 的第一关设成“能不能分出五个角色”。真正的第一关是:任务在人工审核处停住,服务重启后能否用同一个 thread_id 继续;读取超时后会不会把同一个动作再做一遍;人工拒绝能不能压过机器的 candidate。
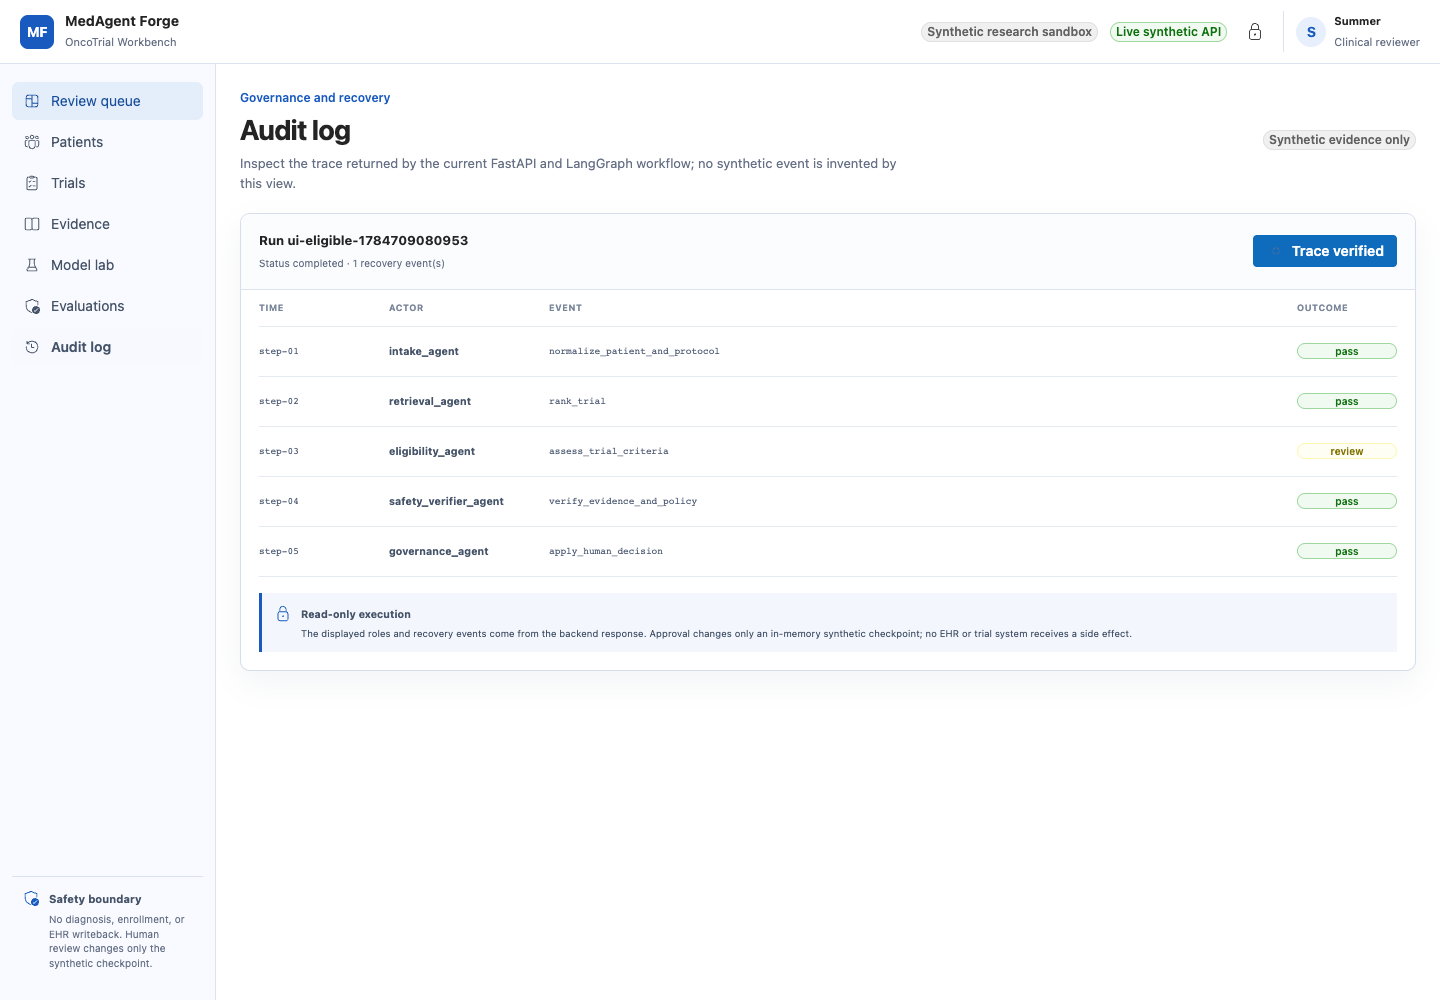
MedAgent Forge 的公开主链已经把这些状态写进 trace。下面这一次运行完成了五个角色步骤,保留了一条 recovery event;页面底部也明确写着它是只读的合成 checkpoint,没有向 EHR 或试验系统写入任何副作用。
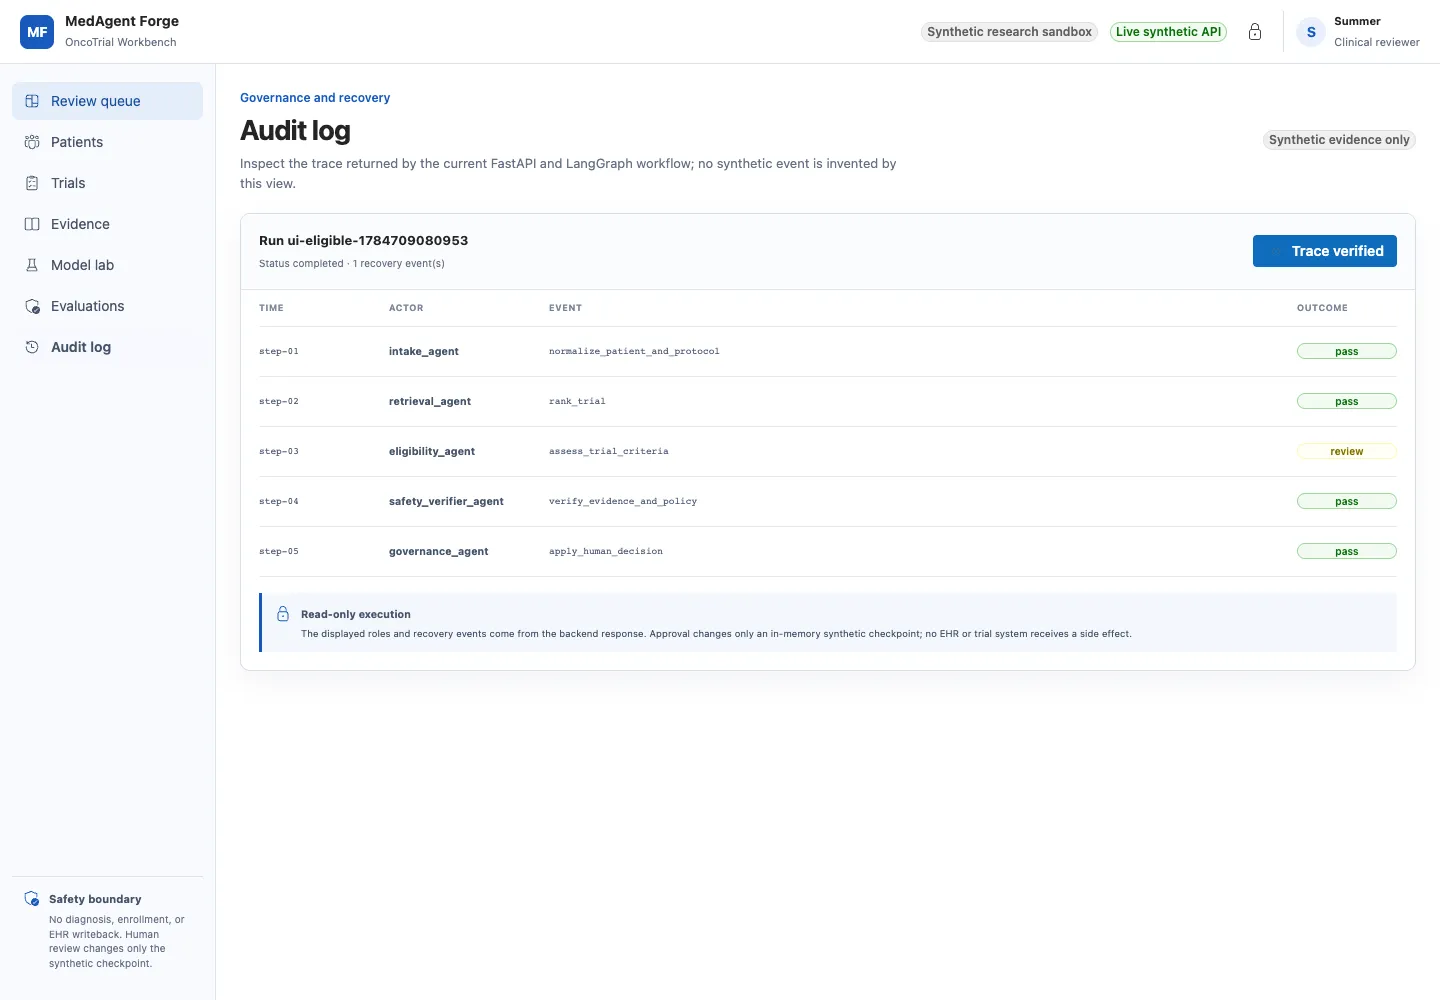
这张图证明的是可查看的工作流轨迹,不是“多 Agent 自动做出了医疗决定”。它甚至没有把模型调用伪装在角色名里:当前五个角色是确定性 Python 组件,模型只是将来可替换的实现。
先拆职责,再决定要不要拆 Agent
这条预筛主链有五个边界清楚的角色。
IntakeAgent 读取合成患者和协议,把不可信文本隔离后整理成标准输入。它不能替其他角色下资格结论。
RetrievalAgent 只排候选试验。它没有写权限,也不决定患者是否符合。
EligibilityAgent 按标准逐条生成绑定 Evidence 的 assessment。它可以返回 unknown 或 conflict,不需要为了让流程继续而猜一个答案。
SafetyVerifierAgent 检查引用、策略和安全阻断。它的职责不是把页面补全,而是指出哪一条结论还不能通过。
GovernanceAgent 在验证器和人工决定都到位后,才更新最终审核状态。人工拒绝时,最终状态保持 rejected,不会被机器建议覆盖。
这才是我愿意使用“多 Agent”的原因:角色之间的数据、权限、验收和失败语义不同。若只是给同一个 prompt 冠上“规划者”“执行者”两个名字,却共享所有上下文和工具,系统会多一层复杂度,却不会多一层安全边界。
角色拆分必须换来责任、权限或验收隔离;三者都没有变化时,不要为了架构图拆 Agent。
LangGraph 管的是状态转换,不是聊天顺序
公开主链很短:
START → ingest → retrieve → assess → verify → human_review → finalize → END每个节点读取显式的 ScreeningState,只返回约定字段。患者范围、试验版本、检索结果、逐条判断、安全结果、恢复事件和 trace 都能进入检查点。
关键差别不在箭头画得多漂亮,而在 human_review 的 interrupt。流程到这里会保存状态并暂停;批准或拒绝回来后,系统从同一个 thread_id 恢复,而不是重新把整份任务跑一遍。
如果有人在这个环节问“为什么不能让模型直接 finalize”,答案也很工程化:模型输出没有执行权限,且最终状态需要对应可追溯的人类决定。减少一步并不会让系统更智能,只会让责任链断掉。
checkpoint 不是 audit log
两者经常被混在一起,但解决的是不同问题。
checkpoint 回答“下一步从哪里继续”。它可以随任务推进更新,也可以按留存策略清理。
审计事件回答“为什么会走到这一步”。它应记录关键状态转换、工具决策、版本和人工决定,并按不同的保留与访问策略管理。
公开演示用的是内存 checkpointer,目的是让读者在离线的合成环境里看清暂停和恢复。生产场景需要持久化状态、独立审计存储以及机构级保留和防篡改策略。用了 LangGraph checkpoint,不等于完成了合规审计。
工具不是函数名,而是一份可执行的说明书
我不让角色直接拿函数句柄,而是让它们经过 ToolManifest。每个工具至少声明:输入输出 schema、需要的权限、风险和副作用、超时与最大重试、幂等键、允许调用的角色,以及是否要求人工批准。
这会把一个常见误区挡在执行器外面。prompt 里写“不要擅自写入”并不是权限控制;没有能力、没有 approval id 或没有 idempotency key 的写入,应在 handler 执行前被拒绝。
项目的端到端场景专门验证了两件事:重复批准只会产生一次副作用;没有授权的 Agent 即使声称自己有权限,也不会越过 handler。它们是工具边界测试,不是语言模型服从性测试。
故障恢复要让用户看得见
演示可以模拟一次 FHIR/fixture 读取超时。Intake 节点做有限重试,把 ingest_timeout_retry_1 写入恢复事件;第二次成功后才继续,最后仍需要人工审核。
这里有三条底线。
有限:无限重试会把一个瞬时故障变成资源泄漏。
幂等:重试任何有副作用的动作时,同一个请求不能执行两遍。
可观察:用户应该看到“发生过一次失败并恢复”,而不是只得到一个干净的成功标签。
可审计的 memory,不是无限聊天记录
这里保留的“记忆”主要是结构化运行状态:任务和协议版本、Evidence 引用、工具结果、人工决定、预算与恢复事件。
项目不保存长思维链,也不把原始医疗文本复制给每个节点。角色之间传递合同与引用,既减少上下文噪声,也缩小敏感数据扩散面。
未来若增加长期记忆,先回答四个问题:谁能写、谁能读、什么时候过期、错误如何纠正或删除。答不清时,memory 只是一个难以审计的新数据库。
亲手跑一次暂停与恢复
启动 API 后,先发起工作流:
curl -X POST http://127.0.0.1:8000/v1/workflows/eligible/start \ -H 'Content-Type: application/json' \ -d '{"thread_id":"demo-001","simulate_transient_failure":true}'返回状态会停在 paused_for_human_review。随后从同一线程恢复:
curl -X POST http://127.0.0.1:8000/v1/workflows/demo-001/resume \ -H 'Content-Type: application/json' \ -d '{"approved":true,"comment":"synthetic review only"}'把 approved 改成 false,检查治理角色是否保留拒绝结果;再用不存在的 thread ID 调恢复接口,应该得到 409,而不是悄悄创建一条假状态。每个动作都只在合成数据路径中执行。
下一篇不再讲架构名词,而是拿十二个端到端场景、红队和消融来验收:哪些绿灯真的代表工程边界,哪些仍然不能叫“医疗验证”。