问题定义:医疗 Agent 不是聊天机器人
研究协调员打开一份候选工作单,第一眼要找的信息是:协议是哪一版、证据来自哪里、哪条条件还缺信息、谁需要签字。这四项里只要有一项答不出来,这份输出就进不了真实工作流–它顶多是个演示。
语言模型能回答“EGFR 是什么”,但这件事和“筛选一个患者是否可能符合某临床试验”之间隔着一整套工程。后者要读版本明确的协议,访问受控数据,逐条计算时间窗,处理缺失与冲突,调用工具,并且留下审计记录。Agent 是在环境中依据状态、工具和策略推进任务的软件系统,模型只是其中一个不确定性部件。
早期医疗 NLP 多做分类、抽取和问答,输入输出的边界是固定的。检索增强生成把外部知识带进上下文,系统仍然停在“给答案”这一步。ReAct 把推理与行动交替组织起来,模型开始可以选择工具;后来的状态图、工具协议和执行环境把 Agent 推向长流程。S29 对医疗工作流来说,真正变化的地方不是文本更像人写的,而是软件开始接触患者数据和外部系统。错误的性质随之改变:从“说错一句话”变成“取错患者、漏掉证据、重复写入或越权”。
本书的任务边界
Section titled “本书的任务边界”贯穿全书的案例是为研究协调员生成 NSCLC 临床试验候选筛选工作单。系统可以召回试验、解析入排标准、整理患者时间线,并对每条标准标出 met / not_met / unknown / conflict。最终的入组判断、患者联系和诊疗决定,都由有资质的人员完成。
明确不做的事:自动诊断、自动开药、自动入组、绕过知情同意、把合成数据当临床证据。FDA 的 CDS 指南、WHO 医疗 AI 治理原则和本地制度都指向同一件事–用途、用户能否独立复核、风险和责任,必须具体到产品场景才有意义。S39S43
读图:工作台先展示不确定的地方
Section titled “读图:工作台先展示不确定的地方”下面这张图来自项目的合成研究沙箱,不是真实患者系统。看中间的逐条条件、左侧待审病例和右侧执行轨迹,它们回答的是“为什么需要人审”,而不是“系统已经做出临床结论”。
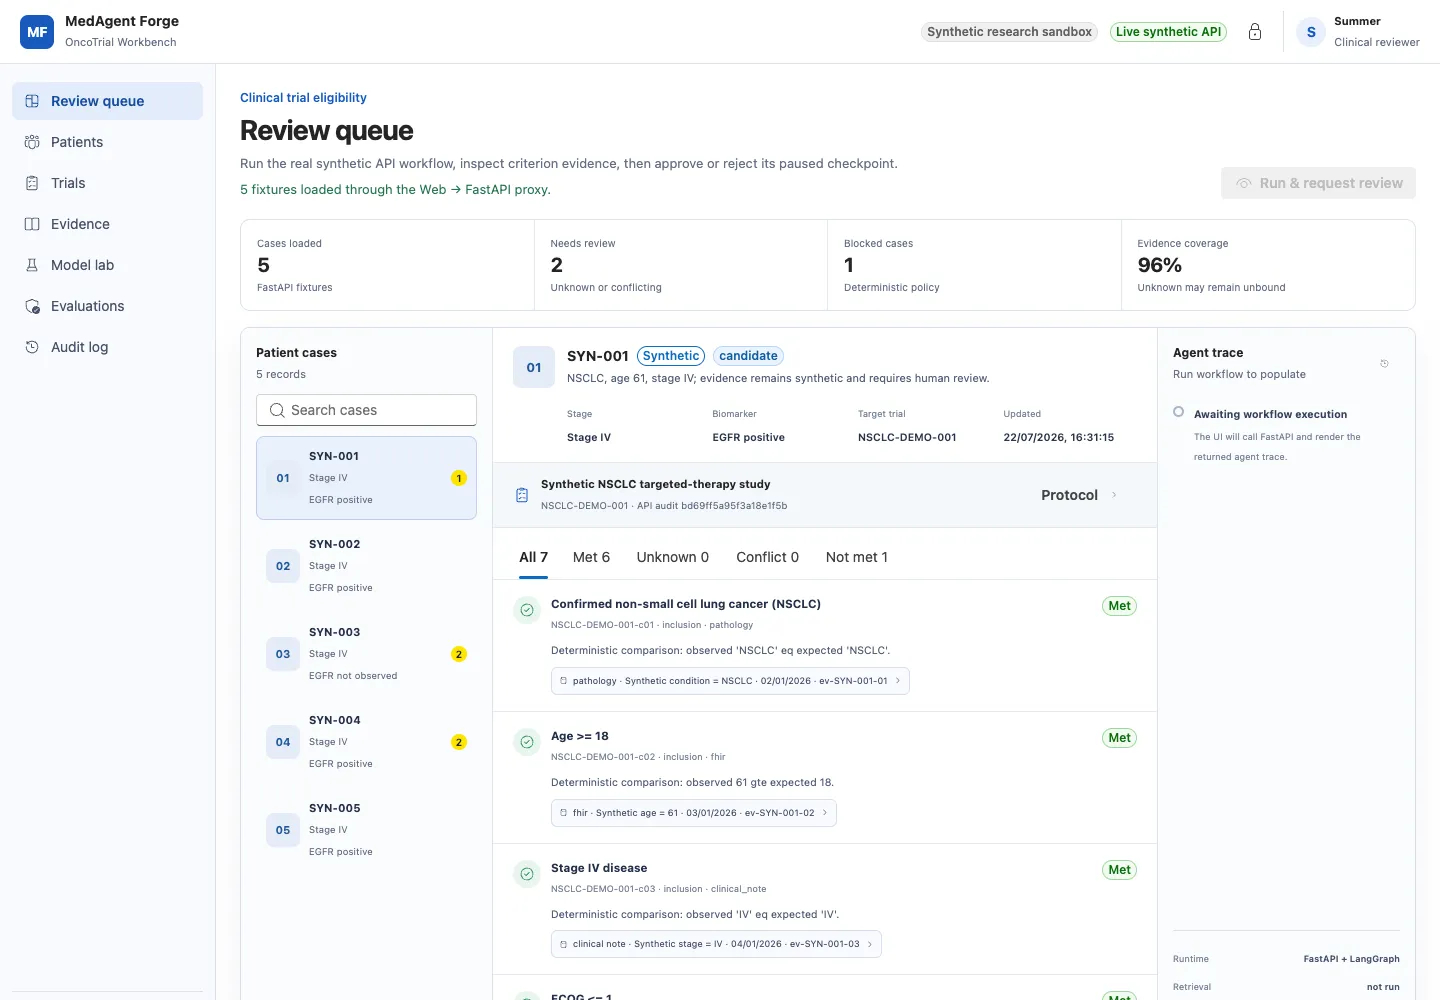
截图能证明的只是界面和工作流的可见性。它不证明任何临床有效性,也不代表真实患者数据。
先写四张边界卡
Section titled “先写四张边界卡”- Intended Use:谁在什么环境下,为何使用输出。
- Non-goals:系统永远不做哪些动作。
- Authority Matrix:每个角色能读、建议、审批还是写入什么。
- Evidence Contract:每个结论必须带哪些原始证据、版本和时间。
这四张卡如果没写清楚,后面再精致的多 Agent 架构,实际效果也只是把模糊的责任自动化了一遍。
代表项目对比
Section titled “代表项目对比”| 项目 | 任务单位 | 值得学习 | 不能直接照搬 |
|---|---|---|---|
| TrialGPT | 召回-逐标准匹配-排序 | 把总判断拆到 criterion 级,理由可定位 | 公开研究结果不是医院生产验证 S30S31 |
| MedAgentBench | FHIR 环境中的执行任务 | 评测行动而非只评问答 | 仓库明确偏研究用途 S32 |
| HealthAgentBench | 多环境、多模态任务 | 覆盖 EHR、影像、病理和终端操作 | 榜单会变,也覆盖不了本地流程 S33 |
实践:把需求变成机器可检查的边界
Section titled “实践:把需求变成机器可检查的边界”运行:
python3 labs/run_lab.py --lab 01实验检查一份 intended_use 是否同时声明了用户、用途、禁用动作和人工复核。试着删掉 human_review_required,看验证器怎么失败。这个实验里一行模型调用都没有,但它是后续所有模型调用的前提。
做法建议分三步:先原样运行拿到基线;再一次只删一个安全字段;最后把报错翻回一句业务语言,比如“没有声明谁复核,所以任务不能进入审核队列”。不这样做的话,边界很容易被写成一段跟代码无关的合规文本。
同一句需求会导向三种不同的产品
Section titled “同一句需求会导向三种不同的产品”假设业务方说:“帮患者匹配合适的临床试验。”这句话至少有三种解释。一种是公共信息搜索–用户输入疾病关键词,系统返回公开试验列表,不读取患者数据,风险相对低。另一种是研究协调员的候选筛选:系统在授权范围内读取患者资料,逐条比较条件,生成待审核工作单,这是本书选的边界。还有一种是自动决定入组并联系患者,它直接改变医疗和研究流程,风险、责任与合规要求跟前两种完全不在一个量级。
架构师要做的不是挑一个听起来最先进的解释,而是把差异问到可执行的程度。谁发起任务?患者是否同意数据被用于试验筛选?系统处理的是公开模拟数据、回顾性研究数据还是实时 EHR?候选列表给谁看?谁能覆盖系统判断?系统能否写回 EHR,写入的是草稿、标签还是正式记录?这些问题里任何一个变了,权限、界面、验证和运维都得跟着变。
在 MedAgent Forge 里,一次任务开始时会生成 TaskContext:purpose=trial_screening、subject=synthetic-patient-001、requester=coordinator-demo、allowed_actions=[read, suggest],加上 expires_at 和 policy_version。就算模型在某份文档里读到“发送邮件给患者”,工具网关也看不到可发送邮件的能力。起作用的不是模型愿不愿意服从,是执行环境根本没授予这个权限。
输出同样不是“推荐入组”。工作单顶部显示协议版本与抓取时间,中部逐条列出四态结论,底部写明缺失信息、冲突和人工签署。关键分子检测缺失时,系统的成功结果是“无法判定,需要补充”,而不是硬凑一个肯定答案出来。拒绝、暂停和升级在这里都是正常的任务状态,不是异常兜底。
模型、工作流、Agent 与自治系统的区别
Section titled “模型、工作流、Agent 与自治系统的区别”- 模型把输入映射到输出,它不知道自己的调用是否具有副作用。
- 工作流由开发者预先规定步骤和分支,适合流程稳定、规则明确的部分。
- Agent 可以根据当前状态选择下一步动作,但选择空间仍由工具和策略限定。
- 自治系统拥有更广的目标和行动权限;在高风险医疗场景中,自治程度越高,所需证据和治理成本越高。
所以本书不会把所有 if/else 都叫 Agent,也不会为了显得“智能”,把确定性的单位换算交给模型。实际跑得住的系统通常是混合体:ClinicalTrials.gov 查询是确定性客户端,数值标准用规则求值,复杂协议片段由模型提出结构化草案,状态图负责推进,人类负责签署。
如何判断这一章真的做完了
Section titled “如何判断这一章真的做完了”标志不是写了一页免责声明,而是能从边界反推出测试:越权写入一定被服务端拒绝;缺证据一定输出 unknown;非 NSCLC 病例进入 OOD;患者 id 与授权 scope 不一致时连读取都不会发生;人工覆盖保留原判断和理由。后面 23 章的技术选择都要能回到这几条不变量上。
任选一个“自动总结病历”的需求,分别写低风险信息整理、临床决策支持和自动执行三个版本的 Intended Use,逐项列出用户、数据、输出、权限、人审和最坏后果。然后试着把第三个版本降权成第二个版本。你多半会发现,最有效的安全设计经常是缩小行动能力,而不是补一段免责声明。
把最终版本交给临床、隐私、安全、产品各一人独立复述。四个人的理解如果不一致,边界就还没写完。
- “仅供参考”不是边界;它没有说谁负责、何时复核、如何拒绝。
- 只限制输出文本而不限制工具权限,挡不住越权行动。
- 有医生参与不自动等于安全:需要说明介入时点、界面信息和可撤销性。
- 本章没有证明该用途在任何司法辖区可部署;上线前必须进行法律、伦理、信息安全与临床治理审查。
医疗 Agent 的第一份代码应当是边界和验证器,而不是提示词。下一章把“候选筛选”拆成可验收的需求。
完整的来源类型、用途与边界见教材来源注册表。
- S29 ReAct 原始论文
- S30 TrialGPT 同行评议论文
- S32 MedAgentBench 官方仓库
- S39 FDA Clinical Decision Support Software Guidance
- S43 WHO Ethics and Governance of AI for Health
资料与延伸阅读
Section titled “资料与延伸阅读”- 想追溯“模型会推理并行动”这条技术脉络,可先读 ReAct 原始论文,再回来看本章为什么还需要权限和审计。
- 想看临床试验匹配如何拆成检索、逐标准判断和排序,可读 TrialGPT 论文 与 作者代码。
- 涉及美国 CDS 监管解释时,查 FDA Clinical Decision Support Software Guidance;跨地区项目还要结合本地法规与机构治理。
- 医疗 AI 的责任、透明度与公平性讨论,可从 WHO《Ethics and Governance of AI for Health》 开始。