总体架构:证据优先而非模型优先
工作台把某条条件标成 met 的时候,该问的问题不是“模型选得够不够强”,而是这个结论能不能点回原始证据、协议换版后能不能重放、服务中断后会不会重复执行。
模型优先的架构从“用哪个大模型”出发,证据优先的架构从“最终判断怎样回到原始事实”出发。前者更容易产出漂亮的回答,后者才有机会通过审计、回归和人工复核。
单轮 LLM 应用通常是 prompt → answer;RAG 变成 retrieve → prompt → answer;工具 Agent 加入行动循环;长流程系统还需要持久状态、人审、策略和恢复。LangGraph 把 durable execution 与 human-in-the-loop 做成核心能力,MCP 把工具和资源的能力协商标准化,OpenTelemetry 解决跨服务轨迹关联。S23S24S27 这些构件各自都成熟,但都没有覆盖一条主线:医疗结论对应的证据对象。
- 来源层:FHIR、DICOMweb、协议、病理、基因和指南。
- 规范化层:单位、术语、时间、患者和版本对齐。
- Evidence Graph:保留事实与原始位置、血缘、置信度。
- 能力层:检索器、解析器、模型、计算器和只读工具。
- 运行时层:状态图、检查点、重试、预算、幂等。
- 治理层:身份、策略、人审、审计、版本和红队门。
- 体验层:协调员工作台、差异、证据和签署。
横向还要再切一刀,分出控制面与数据面。控制面管理工具 manifest、策略、模型和提示词版本、评测门;数据面处理任务状态和证据。这两者一旦混在 Agent prompt 里,既难审计也难更换模型。
一条判断必须沿以下方向前进:
ProtocolVersion → TrialCriterion → PatientTimeline → Evidence[] → CriterionAssessment → VerifierDecision → HumanReview
每个箭头都得能回答四个问题:输入版本是什么、谁生成、能否重放、失败如何恢复。模型可以随时替换,合同不能跟着模型漂。
读图:工作台反过来约束后端
Section titled “读图:工作台反过来约束后端”工作台里每一个条件行都要同时展示结论、来源和当前状态。下面的合成沙箱就是这样组织的–页面不是把模型答案铺开,而是让审核者沿条件和 Evidence 往回看。后端如果提供不了这些对象,前端做得再好看也支撑不了审核。
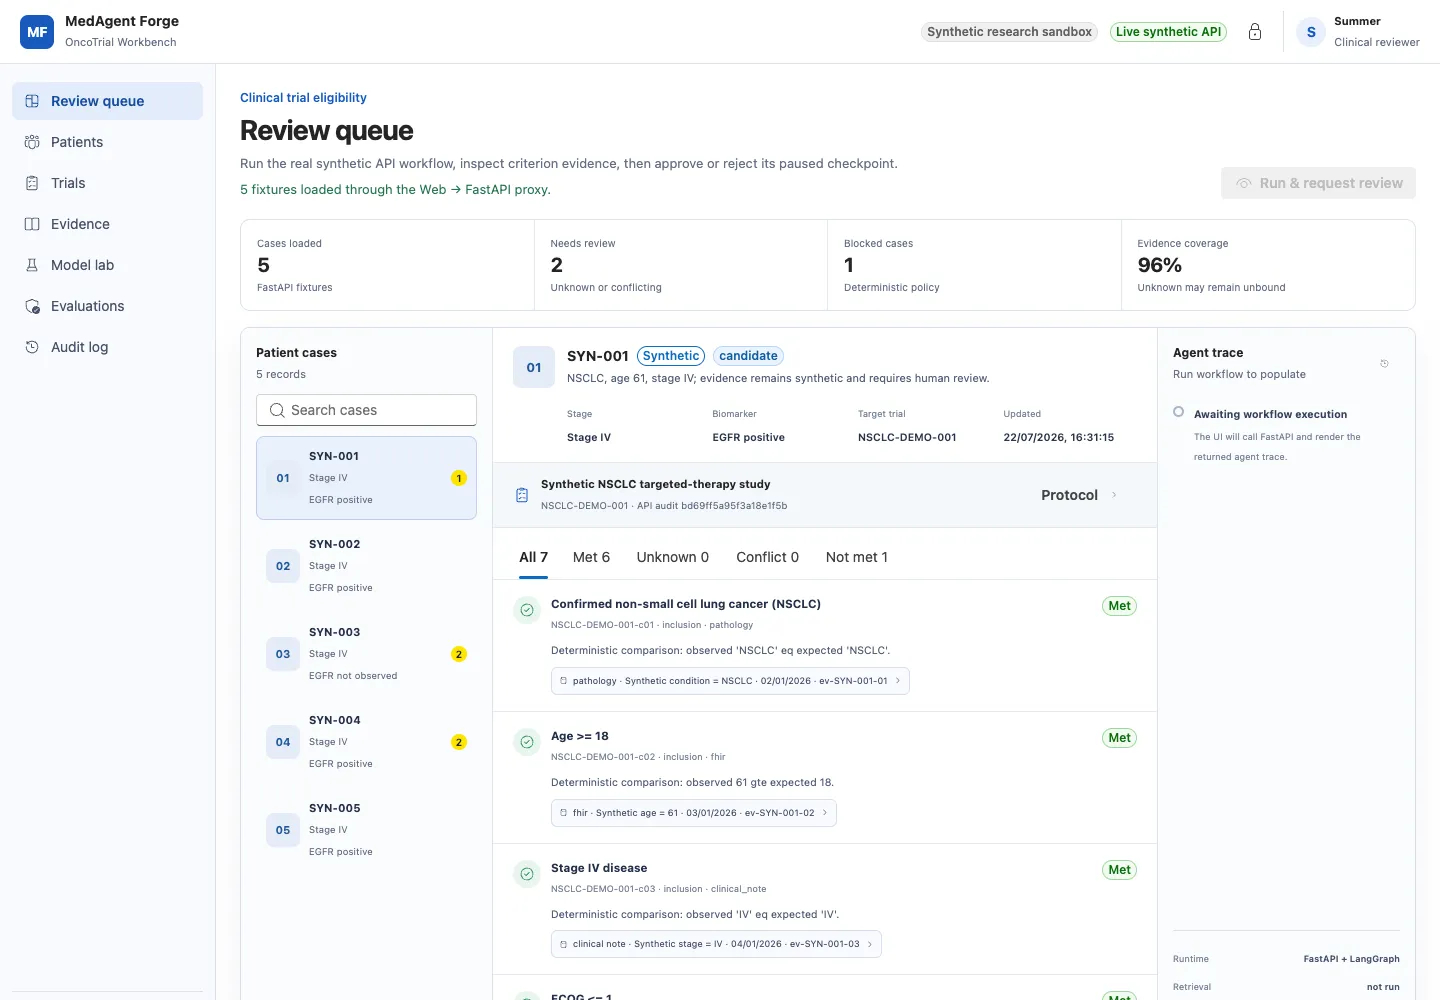
这是项目用合成数据构建的界面证据,说明架构输出应如何被复核,不代表医疗效果或生产部署状态。
项目设计对比
Section titled “项目设计对比”| 项目 | 核心抽象 | 可借鉴 | 需补充 |
|---|---|---|---|
| LangGraph | state + node + edge/checkpoint | 显式工作流、恢复、人审 | 医疗 Evidence 与权限模型 S23 |
| MCP | host/client/server + capability | 工具发现、版本和边界 | 每工具临床风险、患者 scope S24S25 |
| OPA | policy decision | 策略与业务代码分离 | 身份、证据上下文和执行器 S26 |
| TrialGPT | 三阶段匹配 | 任务拆分合理 | 数据版本、治理、执行恢复 S30 |
python3 labs/run_lab.py --lab 03实验把一条评估记录沿七个阶段推进,并拒绝跳过 verify 直接进 human_review。
先让正常路径跑通,再试着跳过 verify。第二次失败时别把它读成“流程更麻烦了”–它把一条无法验证的判断挡在了人工签署之前,这正是想要的行为。
一条 EGFR 证据怎样穿过七层
Section titled “一条 EGFR 证据怎样穿过七层”ClinicalTrials.gov 上某条 inclusion 写着需要特定 EGFR 变异。来源层保存试验 id、API 数据时间戳和 eligibility 原文,患者侧读取一次基因报告。规范化层识别出 EGFR exon 19 deletion,同时保留 assay、标本、采样与报告时间。Evidence 层生成 ev-gen-003,locator 指向原报告字段,content hash 锁定内容。
资格节点读取冻结的 TrialCriterion 和 ev-gen-003,输出 met 草案,它无权修改患者资料。Verifier 检查几件事:evidence 与 patient scope 是否相同、样本时间是否落在协议允许窗口内、变异类型是否真的满足条件、协议版本有没有过期。工作台给协调员同时显示规范化事实和原文位置。签署产生一条新事件,不覆盖机器草案。
这条链路顺下来就能看出为什么只建一个向量库不够。向量库可以帮助发现报告,但它单独表达不了 patient scope、协议版本、采样时间、内容哈希和人工签署。同样也能看出为什么不该让总控模型拿到所有原始数据–每个工具只返回当前任务需要的最小 Evidence。
状态、数据和事件
Section titled “状态、数据和事件”这三个词经常被混着用。状态是任务此刻的可恢复快照,比如当前节点、预算和待审批动作;数据是患者资源、协议和模型输出;事件是发生过的不可变记录。只保存事件,读当前任务会很贵;只保存状态,审计时看不到过程。常见做法是状态表支撑运行、append-only 审计表支撑追溯,再用 Evidence 内容哈希连接外部受控数据。
MedAgent Forge 的数据库不复制整个医院 EHR。FHIR/DICOM 对象留在来源系统,工作数据库保存受限引用、必要的规范化事实和授权上下文,对象存储只接收许可允许的协议与合成资产。向量索引是派生物,随来源版本可重建,它不是事实主库。
架构决策记录
Section titled “架构决策记录”关键取舍写进 ADR,而不是画一张一次性大图:为什么用 R4 而不是假设 R5、为什么工作流层用显式状态图、为什么默认只读、为什么 TrialCriterion 必须人工冻结、为什么初期做模块化单体而不是十几个微服务。每份 ADR 写清上下文、选项、决定、后果和复审触发条件。将来医院全面提供 R5 profile,或者某个模态服务需要独立扩缩,团队才有明确理由重新评估。
部署也应该渐进。第一个可运行版本可以只有 API、worker、PostgreSQL 和本地 fixture;第二步加真实 FHIR sandbox、策略服务和 tracing;只有负载、组织边界或安全隔离确实需要,才拆独立服务。一开始就把所有流行组件放进架构图,调试和数据治理都会更难。
三条架构不变量
Section titled “三条架构不变量”任何 CriterionAssessment 都能解析到同一患者、同一协议版本的 Evidence。高风险动作必须在执行器侧通过策略与审批,模型文本绕不过去。任何长任务都可以在不重复副作用的情况下恢复。框架、模型、数据库都可以换,这三条不能被实现细节冲掉。
性能与安全一起算
Section titled “性能与安全一起算”证据优先不等于无限复制数据。以 task id 为 trace root,只返回 Evidence 摘要和 locator,大影像留在 DICOMweb,协议和公共知识做内容寻址缓存,患者数据不跨任务复用未授权 cache。成本预算按节点记录,先看清主要消耗来自重复检索还是模型调用再优化,不要用删除 verifier 换一个好看的时延数字。
拿任一架构框图,从最终工作单反向追踪到原始资源。哪个箭头说不清版本、授权、失败和重放,那里就是下一份 ADR。如果模型服务宕机后系统无法把任务安全地停在 unknown 或 review,说明架构目前只覆盖了成功路径。
- 微服务数量不是架构成熟度;早期可模块化单体,先把合同稳定。
- Event Sourcing 能追溯,但日志可能包含 PHI;最小化、脱敏、访问控制和保留期限必须同步设计。
- “模型可替换”不表示结果等价;每次更换都要跑任务回归和校准。
- 证据图并不自动消除源数据错误,只让错误更容易定位。
完整的来源类型、用途与边界见教材来源注册表。
资料与延伸阅读
Section titled “资料与延伸阅读”- LangGraph:关注状态图、checkpoint 和人工介入如何组合;医疗数据合同需要在框架之外定义。
- MCP Specification 与 MCP Security Best Practices:理解工具能力协商和授权边界。
- Open Policy Agent:了解为什么策略决策不应藏在 prompt 中。
- OpenTelemetry Specification:建立可关联的轨迹、指标和日志,同时避免把敏感原文写入 trace。