复盘与面试:用证据证明架构能力
面试里最容易失分的不是承认“还没跑训练”,而是把一个 smoke test 讲成模型提升。更可信的讲法是马上拿出命令、工件、失败条件和当前状态,让对方自己判断证据到哪一层。
高级架构师作品不是技术名词清单,而是可追溯的决策链:问题是什么、为何这样拆、基线是什么、增加复杂度带来什么可测收益、哪里失败、如何限制风险、别人怎样复现。MedAgent Forge 最终要成为这条决策链的可运行证据,而本书负责公开解释每一步怎样产生、怎样失败与怎样验收。
来龙去脉:从“我会”到“证据表明”
Section titled “来龙去脉:从“我会”到“证据表明””不要说“我会 FHIR、多 Agent、GRPO”。改成:
- FHIR:给出受控 Bundle、patient scope 测试、时间线与错误资源案例。
- 多 Agent:给出责任/权限表和单 Agent 消融;无收益则删。
- GRPO:给出 verifier、奖励组件、投机案例与真实 run;若只有 smoke test 就明确写 smoke test。
- 医疗可靠性:展示 12 个 TaskPackage、安全硬门、失败轨迹和人工覆盖审计。
这种表达与 CONSORT-AI、SPIRIT-AI、DECIDE-AI 所强调的清楚描述用途、数据、流程、人机交互和评估边界一致:可报告性不是包装,而是让结果可判断。S40S41S42
能力证据矩阵
Section titled “能力证据矩阵”| 能力 | 代码证据 | 评测证据 | 决策证据 | 边界 |
|---|---|---|---|---|
| 医疗数据 | FHIR/DICOM/OMOP adapters | schema/时间/跨患者测试 | 交换与分析模型分层 | 无真实 PHI |
| 模型适配 | model adapter/训练配置 | 冻结任务回归 | 先基线再训练 | 未跑不报结果 |
| Agent Runtime | 状态图/checkpoint/idempotency | 故障注入 | 显式状态替代隐式 loop | 不承诺 exactly-once |
| 多 Agent | handoff/权限 | 单多 Agent 消融 | 按责任拆 | 无收益即回退 |
| 安全治理 | policy/threat model | 红队/硬门 | 默认只读 | 非合规认证 |
5 分钟:问题、核心数据流、三项最难取舍、可运行证据、边界。15 分钟增加数据合同、状态图、评测与一次失败。45 分钟现场运行 lab/测试,展示一条 unknown、一次越权拒绝和一次 checkpoint 恢复。
面试官追问“为什么不用更强模型”时,不争论品牌,展示错误分类:如果主要错在取数、版本和权限,更强模型不是第一修复;若冻结环境证明能力瓶颈,再展示适配实验。
| 外部项目 | 你应学什么 | 你必须补什么 |
|---|---|---|
| TrialGPT | 三阶段试验匹配 S30 | 企业运行时、四态、人审治理 |
| MedAgentBench | FHIR 执行任务 S32 | 本地业务验收和安全策略 |
| HealthAgentBench | 多模态任务广度 S33 | 旗舰项目的纵向业务闭环 |
| MedGemma | 医疗模型基线 S14 | 自己的任务适配与失败报告 |
实践:先让一句没有证据的“已完成”在自检里失败
Section titled “实践:先让一句没有证据的“已完成”在自检里失败”python3 labs/run_lab.py --lab 24python3 scripts/validate_book.py实验生成“声明、证据、状态”矩阵。只有存在路径或明确标注 planned 的声明才通过;任何写成 complete 却没有可检查证据的条目都失败。可以先加一条没有路径的完整声明,确认门拒绝它。这会阻止简历先于实现。
移动端截图要看三件事:顶部明确写着临床试验资格审阅,队列只加载合成 fixture,unknown 或冲突案例仍保留在人审列表里。它适合展示受控工作台的阅读边界,不证明复杂的真实审核可以安全地在手机上完成。
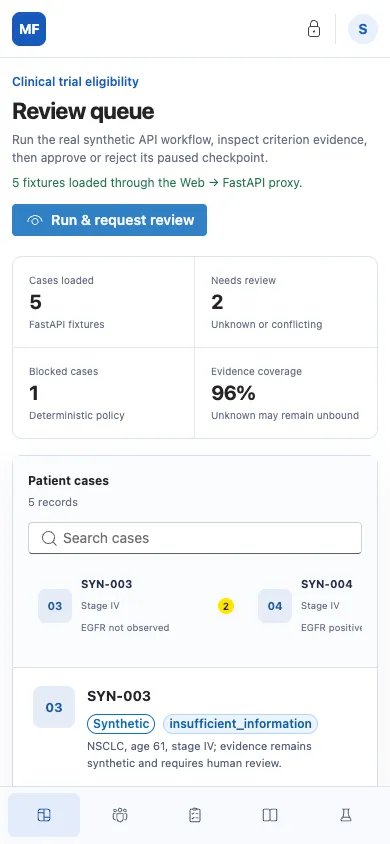
这也是复盘里应保留的限制:响应式界面可以帮助阅读和演示,但不会替代权限、证据和正式用户研究。
一条可信的项目叙事
Section titled “一条可信的项目叙事”先说明为什么选择 NSCLC 试验候选筛选:它同时要求公开试验检索、患者纵向证据、多模态、逐条件推理、人审和安全,却能明确限定为研究工作流支持,不需要冒充自动诊疗。然后展示从边界到架构的因果链:因为最终决定需要人工,所以工作单围绕 Evidence/四态;因为任务跨小时,所以 runtime 有 checkpoint;因为数据/工具高风险,所以默认只读、patient scope 和 verifier 独立。
再展示“先简单、后复杂”:无训练检索/规则基线在前,医疗模型和 SFT 只针对实测瓶颈;单 Agent/确定工作流在前,多 Agent 只有权限或并行收益才保留;DPO/GRPO 只处理偏好/可验证行为。这样的叙事比一次展示所有框架更能证明架构判断。
作品证据的四个层级
Section titled “作品证据的四个层级”Level 1 文档:PRD、ADR、threat model、Model/Dataset Card。Level 2 可运行:一条命令启动合成 demo、24 labs、CI。Level 3 实验:冻结 TaskPackage、baseline、消融、失败报告。Level 4 影响:外部 issue/PR、真实用户复现、讲座/文章引用。前一级不能替后一级;网站清楚显示完成状态。
当前本书真实达到的是教材、来源 registry 与标准库 labs;它不代表 flagship 服务、训练 run、视频或临床研究已完成。Claim-to-evidence gate 让这种差异可见。后续每完成一项,以 commit、artifact、报告和演示更新状态,而不是手改简历形容词。
架构面试的追问准备
Section titled “架构面试的追问准备”“为什么是 FHIR + OMOP?”回答交换与分析用途不同,并给实时 Evidence/队列初筛例。“为什么多 Agent?”先给单 Agent 消融;按权限/模态拆,不按人设。“怎么防幻觉?”说明缺证据四态、引用验证和 tool policy,而不是声称消除。“怎么证明安全?”展示 threat model、hard gates、越权 TaskPackage 和事故演练,同时承认残余风险。
“为什么训练?”先给 error taxonomy 与无训练 baseline;若没有真实训练结果,就说当前只完成数据/环境门和计划。诚实说 not-run 比编造提升更体现高级工程判断。
GitHub 仓库的阅读路径
Section titled “GitHub 仓库的阅读路径”README 用 90 秒讲问题、边界、架构、quickstart、真实状态;PROJECT.md 是总账;docs/ 放决策与证据;examples/ 使用合成 fixture;evals/ 可重跑;release 附 artifact/hash。issue label 区分 bug、data、evaluation、security;security 漏洞走私密渠道。英文 README 服务国际开发者,中文教材讲原理与过程。
教程仓库与实现仓库互相链接但不互相伪造。章节 demo 指向已存在命令;实现未完成的截图/结果不发布。网站 importer 以 book.yaml 为单一清单,修改正文 push 后自动构建;引用 snapshot 让读者知道“热门/当前”有日期。
5/15/45 分钟演示脚本
Section titled “5/15/45 分钟演示脚本”5 分钟只跑合成患者:缺 EGFR → unknown、越权写 → 拒绝、trace → Evidence。15 分钟增加协议条件树、FHIR timeline、checkpoint 恢复与单/多 Agent 取舍。45 分钟打开代码和 TaskPackage,重放失败、切换模型 route、解释评测与 threat model;所有演示预置离线 fixture,避免现场网络失败或患者数据暴露。
失败如何成为优势
Section titled “失败如何成为优势”保留一份“我们删掉了什么”:多 Agent 若无收益被回退,DAPT 若任务不改善被停止,影像模型若 OOD 被限制。写出假设、数据、结果和后续。高级架构师不是从不失败,而是用低成本实验让失败在上线前发生,并能解释为何停止。
90 天后的维护
Section titled “90 天后的维护”按月/发布前重核来源、模型/协议/API、依赖和 benchmark;按变更重跑 TaskPackage;检查链接、许可和图片清单;处理读者 issue;把真实复现结果与最初假设对照。知识库的可信度来自更新机制,不是首发篇数。
章末行动清单
Section titled “章末行动清单”执行 lab 24 与内容验证;为每项简历声明贴 evidence URL/commit;录制合成 demo;邀请一位 Agent 工程师、一位医疗/研究流程人员和一位安全工程师分别 review;公开限制和 roadmap。任何 reviewer 发现“已完成”没有证据,先降级状态再补实现。
失败边界与开放事项
Section titled “失败边界与开放事项”作品集最重要的失败边界,是让未完成和未验证保持可见。把状态降为 planned 或 not-run 不是减分,而是让下一步的实现和评测有可信起点。
- 本书教材和标准库实验完成,不等于旗舰实现、模型训练、视频和临床验证完成。
- 热门项目与 API 会变化,发布前需重跑来源与依赖核验。
- 开源影响力需真实用户、issue、引用和贡献,不能由页面数量代替。
- 真实医疗部署还需伦理、隐私、安全、法律、临床与运维多方治理。
资料与延伸阅读
Section titled “资料与延伸阅读”以下参考资料用于把项目复盘放回外部方法与报告边界中阅读。它们不会替代当前仓库的命令、工件和状态记录。
- S14 MedGemma:回看医疗模型材料怎样陈述 Intended Use、验证和许可边界。
- S30 TrialGPT:比较公开试验匹配的数据链与本项目的工作流取舍。
- S32 MedAgentBench:参考 FHIR 执行环境如何报告任务完成,而非只给答案分数。
- S33 HealthAgentBench:理解多模态医疗 Agent 的公开环境和不宜直接外推的范围。
- S40 CONSORT-AI:报告 AI 临床试验时应公开的系统、数据和人机交互信息。
- S41 SPIRIT-AI:从研究方案阶段写清 AI 干预与评估边界。
- S42 DECIDE-AI:早期临床评估如何公开工作流、风险和人机协作。