医疗基础模型与 MedGemma 适配
同一条协议解析任务,模型可能写出一段读起来很顺的答案,却在 CriterionAssessment 的字段、工具范围或证据版本上出错。所以看到“医疗模型”四个字的时候,先别急着下权重,把模型卡摊开来看:支持哪些模态、输入能多长、覆盖哪些语言、训练数据的边界在哪、许可怎么写、预期用途是什么、测过哪些任务、已知限制有哪些、要什么硬件、怎么服务。这一串问题决定了 MedAgent Forge 能把它放在流程的哪一段,也决定了它不能越过哪一段边界。排行榜名次说明不了这些,模型卡才是评审时能拿出来的东西。
医疗模型是怎么来的
Section titled “医疗模型是怎么来的”通用预训练模型靠海量文本学语言和知识,医疗模型在这之上再用医学文本、图像或指令做适配。Google Health 把 MedGemma 定位成医疗 AI 的开发基础,官方仓库描述了文本和图像理解两类变体,并且强调开发者需要针对下游场景自己做适配和验证。S14S15 这跟“开箱即用的临床产品”是两回事。
真正麻烦的是 benchmark 转移:医学问答分数高,不代表会正确调用 FHIR;胸片任务好,不代表会处理 CT 体积;英文数据上的结论,不代表中文病历上等价。许可也是分层的,仓库代码是 Apache-2.0 不意味着模型权重是同一套。S14
模型路由表与上线顺序
Section titled “模型路由表与上线顺序”落到工程上,先建一张模型路由表:任务、模态、隐私级别、模型、量化、最大输入、输出 schema、成本/时延、失败回退。协议解析用文本模型,影像 evidence 交给专门的视觉模型,确定性的单位换算根本不用模型。
上线顺序也别跳级:规则/检索基线 → 通用模型 baseline → 医疗模型 zero-shot → 小规模适配。每一步都在同一个冻结的 TaskPackage 上比较正确率、unknown 校准、引用、工具轨迹、成本和安全。本地部署能减少数据外发,但它本身不等于安全,模型来源校验、依赖安全、访问控制和审计一样都要做。走云端模型则要把数据保留、是否用于训练、地域和合同条款问清楚。
几类方案的取舍
Section titled “几类方案的取舍”| 方案 | 强项 | 选择条件 |
|---|---|---|
| MedGemma | 医疗文本/图像开发基础 S14 | 接受其许可并完成任务验证 |
| 通用前沿模型 | 工具调用/推理常较强 | 数据政策和成本允许,仍需评测 |
| 规则/小模型 | 稳定、低成本、可解释 | 任务边界清楚 |
| 多模型工具箱 | 各模态专长 | 路由、版本和运维成本可控 |
先跑模型卡门检,再讨论下载
Section titled “先跑模型卡门检,再讨论下载”python3 labs/run_lab.py --lab 13实验读取一份模型卡摘要,逐项过门检:license、intended use、modalities、context、evaluation、limitations,缺一不可。缺哪一项,这条 route 就留在候选状态,而不是拿“参数大”去补信息。它不下载权重,也不报告模型效果;等拿到模型访问权之后,可以替换 adapter 做扩展实验。
图里先看两个区域:左上是合成数据工作台,中央的 Model lab 把 CPT、DAPT、SFT、LoRA、QLoRA、DPO 和 GRPO/RLVR 放进同一份可回查的工件列表;右上和下方的边界说明写清了只使用合成证据、没有临床有效性声明。
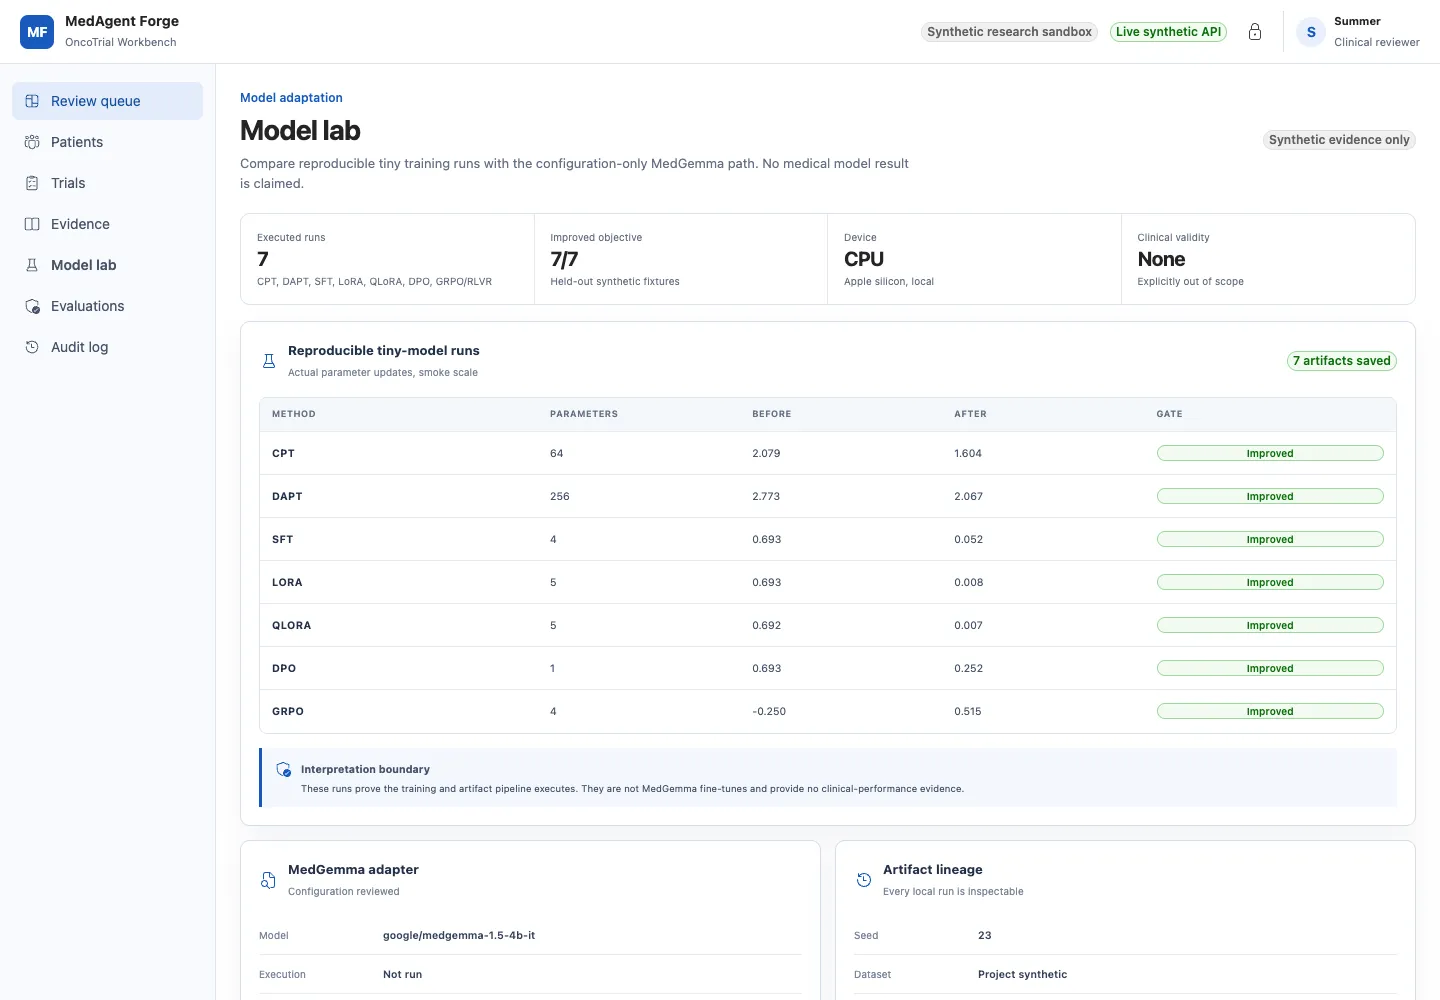
这张图能证明的是配置、训练 smoke 和工件链路可以被审阅。它不能证明 MedGemma 已经完成微调,也不是任何临床性能结果。
五类任务,五种路由需求
Section titled “五类任务,五种路由需求”MedAgent Forge 里至少有五类跟模型相关的任务。协议结构化要长文本、严格 JSON 和否定/时间理解;患者病历抽取要隐私与引用;试验精排要成对相关性;影像工具要明确的模态与预处理;最终工作单需要受约束生成。这五类未必由同一个模型做得最好。
所以 ModelRoute 不能只是一个 model name,它是一份可审计的配置:task type、provider、model/weights revision、quantization、prompt/template、tokenizer、input policy、output schema、timeout、cost ceiling、fallback 和 evaluation suite。一次任务开始时就把 route snapshot 写进状态,恢复的时候才不会无意间切到新模型上。
确定性规则始终是路由选项之一。年龄和单位比较用程序算,检索融合用算法,只有语义歧义才交给 LLM。影像模型返回结构化发现,不被授权做 trial-level 的结论。总控模型看到的是 Evidence 摘要和工具 schema,不直接接触无边界的原始数据。
官方材料怎么读
Section titled “官方材料怎么读”从官方仓库和开发文档确认模型变体、模态、模型卡、许可与 Intended Use,仓库代码许可和模型权重许可要分开核验。S14S15 官方报告的 benchmark 当“候选能力证据”看,不是本任务的性能。接着查输入格式、图像预处理、聊天模板、量化支持和已知限制,锁定 revision;模型卡如果没覆盖中文 NSCLC 协议或特定 CT 任务,就在 gap 表里明确写出来。
然后做最小 inference validation:同一 fixture 跑多次,检查 schema、token 上限、拒答、显存和失败;再跑冻结的 TaskPackage。只有结果记进实验报告之后,才能写“在某环境/版本/数据上观察到”。本书当前只完成了 model-card gate,所以 evaluation=not-run 就是正确的状态。
Level 0 是规则/关键词/检索,Level 1 是通用模型受约束 zero-shot,Level 2 是医疗模型 zero-shot,Level 3 是 prompt/RAG 调整,Level 4 才轮到 SFT/偏好/RLVR。每一级用相同的数据 snapshot 和评测,报告增量和成本。假如 MedGemma 在协议 JSON 上不如通用模型,但在某类医疗图像工具上更好,那就路由组合,没必要宣布某个模型“全面胜出”。
商业模型对照也值得做,它能给出能力上界或者不同的 tool calling 基线,代价是受数据合同、费用、网络和可复现性限制。对任何 provider 都封装同一份 adapter 合同,别让业务代码直接依赖专有消息格式。
多模态输入需要预处理
Section titled “多模态输入需要预处理”模型对分辨率、归一化、图像数量和提示模板都有要求。DICOM 体积不能未经设计就变成若干张 JPEG,病理 tile 还需要聚合。模型 adapter 的输入应该是 MediaEvidenceRequest,里面带合法获取的图像引用、预处理 manifest、任务和输出 schema;adapter 生成 input hash,输出带 weights/preprocess version。
评测也要分层:图像质量门、模型任务指标、结构化输出、downstream criterion 成功。输入如果不是官方支持的模态,必须标成 OOD,别用“医疗多模态”四个字盖过去。
mac-local 与 cuda-full 两套 profile
Section titled “mac-local 与 cuda-full 两套 profile”mac-local 可以用 MLX 这类 Apple Silicon 工具验证小模型或量化模型的 adapter、数据和训练 smoke;cuda-full 为标准 Transformers/PEFT/TRL 和更大的实验准备。配置文件只记录目标,不预先写吞吐和可训练规模。S22 真正的结果必须落到 hardware.json:芯片、内存、OS、依赖、模型 revision、峰值内存、时延、样本数。
本地跑不稳某个模型,就回退到小模型或者远程受控环境。别把“128GB 统一内存”直接换算成可用的训练 batch–权重能加载成功,跟任务能跑通、数值稳定、许可合规完全是两码事。
供应链与退役
Section titled “供应链与退役”模型文件要验证来源和 hash,禁止动态执行未经审查的 remote code;依赖锁版本并做漏洞扫描,服务账号只读权重。新模型进 canary/shadow,旧模型在回滚窗口里保留。触发退役的时候删 cache、更新 SBOM 和模型 registry,同时保证历史任务仍然能解释当时用的是哪个版本。
模型选择评审表
Section titled “模型选择评审表”一页决策要回答这些:具体的任务瓶颈是什么,为什么规则/RAG 不够,候选模型的许可和数据政策如何,需要什么硬件,任务和安全指标是什么,回退是什么,成本多少,谁批准,什么时候复审。没有冻结基线就不批准训练,没有模型卡与许可就不进入下载,没有 TaskPackage 就不做比较。
统一 adapter 的接口
Section titled “统一 adapter 的接口”adapter 接收 ModelRequest(task, input_refs, schema, policy, seed),返回 ModelResponse(structured_output, usage, model_revision, input_hash, warnings)。provider 特有的图片格式、tool call 和错误都在 adapter 内部转换,业务层不依赖某家 SDK。超时、内容过滤、上下文超长和无效 JSON 一律映射成显式 error,由 orchestrator 决定 fallback 还是转人工–adapter 不能自己静默重试到另一个模型上去。
从这里往下做
Section titled “从这里往下做”先运行本章的 model-card gate,再给候选的 MedGemma 和通用模型各填一份真实卡片;接入合成 fixture 之后生成第一份 baseline-report.json。报告还不存在的时候,项目页就只展示计划和接口截图。留一个问题:如果医疗模型的知识问答更好但 tool calling 更差,你会选路由、SFT,还是保持通用总控加医疗工具?答案得由任务的错误分布决定,不能靠偏好。
阅读顺序与退出策略
Section titled “阅读顺序与退出策略”先读 MedGemma 官方 README 与 Intended Use,再读具体模型卡和许可证,最后读 adapter 框架文档,不要从二手榜单倒推用途。S14S15 把每条官方能力映射到本地的 TaskPackage,映射不上的只写“未验证”。模型更新之后重做这张映射,旧 revision 的报告保留。
架构评审还要问退出策略:模型下架、许可变化、价格上涨或者安全回归的时候,哪个规则/模型 route 接管,用户看到什么,历史记录怎么解释。没有退路的模型选择,等于把供应商的决定变成医疗流程里的单点。每个 route 的批准人和复审日期也要进 registry,不能只留在会议纪要里;过期的 route 默认停止接新任务。
模型在某个公开 benchmark 上表现好,只能作为进入下一轮验证的理由。它不能替代数据合同、路由回退、冻结任务评测或人工批准。
- 参数量与医疗可靠性没有单调关系。
- 量化会改变输出分布,必须重新校准和回归。
- 模型卡是供应方说明,不替代独立验证。
- 未经真实测试,不声称 M3 Max 可在某吞吐下运行某模型。
资料与延伸阅读
Section titled “资料与延伸阅读”以下参考资料都登记在来源注册表里。阅读时先确认适用范围,再把可用的事实写进 route,别把宣传页当成性能结论。