多 Agent 编排:按责任边界拆分
把一个 prompt 拆成八个角色,最常见的结果不是更聪明,而是八份互相矛盾的摘要、更多 token 和更难追的权限。先把单 Agent 跑通,再问每个拆分是否真的带来边界收益。
多 Agent 只在三种收益可验证时成立:权限隔离、不同模态或工具的专业边界、可并行的独立任务;以及独立验证者需要与执行者解耦。
来龙去脉与痛点
Section titled “来龙去脉与痛点”单 Agent 工具循环简单,但上下文、权限和任务日益膨胀。supervisor、handoff、blackboard、并行 worker 等模式由此流行。LangGraph 支持子图和状态编排,但框架只提供机制。S23 多 Agent 的新失败包括:信息在 handoff 丢失、两个 Agent 互相确认错误、并行写冲突、上下文与成本倍增。
核心原理:按责任划分
Section titled “核心原理:按责任划分”- Protocol:协议解析草案,无患者写权限。
- Timeline:读取 FHIR,生成时间线。
- Imaging / Pathology-Genomics:调用各模态只读工具。
- Retrieval:试验召回和排序。
- Eligibility:逐标准匹配,只写工作状态。
- Evidence:检查引用与知识版本。
- Safety Verifier:无业务写权限,只能通过、拒绝或升级。
- Orchestrator:状态、预算、重试和人审,不替代专业判断。
handoff 传结构化 package:task、scope、input refs、expected output、budget、deadline、provenance;禁止只传一段聊天摘要。共享状态采用 append-only evidence + 版本化 assessment,避免最后写入者覆盖事实。
| 模式 | 适合 | 代价 |
|---|---|---|
| 单 Agent + 工具 | 默认基线、短流程 | 上下文/权限可能膨胀 |
| Supervisor | 中央调度和统一预算 | 单点瓶颈/过度总控 |
| Handoff | 专业所有权明确 | 交接丢信息 |
| Blackboard | 多来源渐进汇聚 | 冲突和并发控制复杂 |
| 并行 map-reduce | 独立 criteria/模态 | 合并和工具限流 |
先比较单线程与并行,再决定要不要拆角色
Section titled “先比较单线程与并行,再决定要不要拆角色”python3 labs/run_lab.py --lab 20实验模拟 supervisor 将三个独立 criterion 分派给只读 worker,再由无写权限 verifier 聚合;权限表阻止 imaging worker 查询基因工具。最后比较单线程与并行的“节点数/结果一致性”,不虚构真实时延收益。如果你把 verifier 与 worker 合并后所有安全检查仍相同,就没有理由因为角色名字好听而保留复杂编排。
图里应先看第二列的 actor 和第三列的 event:每一步由不同责任域写入,最终只有一个 review 状态留给人审。页面同时标注为合成证据、只读回放,因此它展示的是审计路径和恢复事件,不是实际 EHR 或试验系统的副作用。
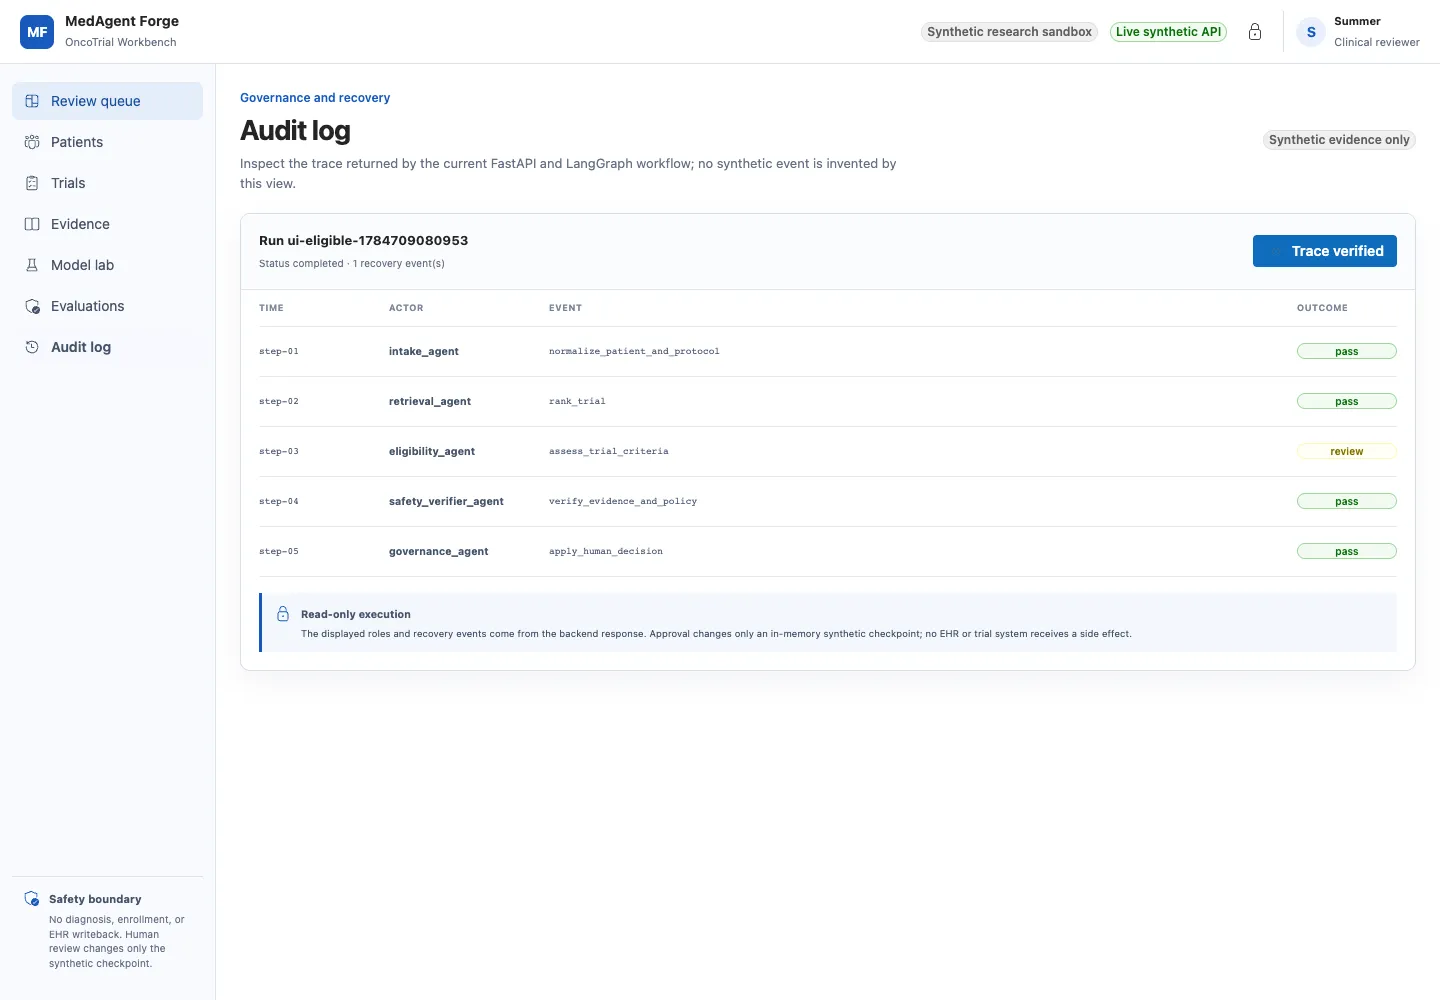
多 Agent 的工程价值在于这种可追溯的责任边界,而不是页面上角色数量越多越好。
贯穿实例:一个试验怎样被多个责任域处理
Section titled “贯穿实例:一个试验怎样被多个责任域处理”Orchestrator 先读取冻结 Protocol Tree,把 criteria 按 Evidence requirement 分组。Timeline Agent 只读 FHIR,Imaging Agent 只读当前 patient 的 DICOM,Genomics Agent 只读报告 adapter;三个 worker 获得相同 task/patient snapshot,但不同 tool allowlist。它们返回 Evidence,不返回最终资格。
Eligibility Agent 对每条 criterion 求值,Evidence Verifier 检查引用;Safety Verifier 检查 scope/version/policy,并且没有任何业务写工具。Orchestrator 合并状态后创建待人审草稿。某个 worker 超时只影响相关 criteria,其他 Evidence 保留;预算决定重试还是 unknown。
这里有七个逻辑角色,但不必是七个独立服务或七个不同模型。早期它们可以是同一进程里的子图节点,权限由 gateway 按 agent identity 强制。角色是责任/合同边界,不是部署数量。
什么时候拆,什么时候不拆
Section titled “什么时候拆,什么时候不拆”拆分打分四项:需要不同权限吗?需要独立扩缩/硬件吗?可以并行吗?需要独立验证吗?如果全否,保留单 Agent/工作流。协议解析、图像和基因工具可能有不同计算与数据边界,适合分;简单年龄规则没必要独立 Agent。
把“研究员、批评家、总结者”放在同一模型和上下文里相互聊天,通常缺少真正独立性。一个 verifier 要独立,至少要有独立规则/隐藏金标/权限,必要时模型多样性;但多模型投票也不是事实证明,最终仍看 Evidence。
handoff 合同
Section titled “handoff 合同”TaskPackageRef 包含 parent task、subtask id、agent role、purpose、patient/trial snapshot、input evidence refs、expected output schema、allowed tools、budget、deadline 和 trace context。worker 不接收全部聊天历史。返回结果带 input hash、tool ledger、output Evidence 和 warnings。
handoff 验证接收者、scope 和 schema;重试使用同 subtask/idempotency。如果 supervisor 修改问题,生成新 subtask version。自然语言摘要只作辅助,不作为唯一上下文。
共享记忆与 blackboard
Section titled “共享记忆与 blackboard”黑板保存 append-only Evidence/Assessment patch,每个角色只能写自己的 namespace;merge 用版本和内容 hash。长期“记忆”不应保存患者事实跨任务复用;患者数据按授权和保留期隔离。可复用的是公开协议解析、工具元数据和去标识的失败模式,不是具体患者记忆。
并发冲突包括两个 worker 写相同 criterion、协议版本变化、重复 evidence。使用 optimistic version、dedupe key 和 deterministic reducer;冲突进入明确状态,不由最后写入覆盖。
supervisor 的局限
Section titled “supervisor 的局限”中央 supervisor 可统一预算和路由,但它若是自由生成模型,会成为单点错误。MedAgent Forge 用确定性 routing 表处理大部分分派,模型只解决歧义;每次分派通过 scope policy。supervisor 不能给自己扩权,也不能覆盖 verifier hard fail。
在同一 TaskPackage 比较:确定性工作流;单 Agent + 全部只读工具;多 Agent 同模型;多 Agent 专业模型。报告任务成功、引用、安全违规、恢复、P95、token/成本和人工负担。给每种架构相同工具与预算,避免“多 Agent 用更多算力”造成虚假优势。
进一步做 role ablation:移除 verifier、合并 imaging/genomics、取消并行。如果多 Agent 只提高 token 没有提高可靠性,生产选简单方案。架构文档可保留实验,但简历不能把角色数量当成果。
worker 失败返回结构化 error,不用聊天说明。Orchestrator 根据 retryable、required/optional 和 budget 决策。部分结果携带 completeness;关键模态失败时 trial status unknown。并行任务取消需传 cancellation,避免 orphan tool calls。写动作集中在独立审批节点,不让多个 worker 争抢副作用。
多 Agent 安全的额外问题
Section titled “多 Agent 安全的额外问题”一个 worker 的恶意/错误 Evidence 可能污染共享黑板,handoff 可能放大 prompt injection,agent identity 可能被伪造。每个写入带 signer/runtime identity、schema、source 和 hash;接收者不把前一 Agent 自然语言当高优先级指令。Tool gateway 从真实 workload identity 判权限,不接受 payload 里的 role。
多 Agent 也扩大供应链和可观测数据。限制每个 role 的模型/provider/工具,患者 context 不向不需要的 worker广播。trace 可关联,但 UI/日志访问按角色过滤。worker 被撤销权限时进行中 task 应停止或重新授权。
并行只缩短独立关键路径,不能消除共同 FHIR/模型限流。估算 DAG critical path、每节点队列/服务时间、并发上限和 merge 开销。如果三个 worker 都调用同一模型 provider,理论并行可能变成 429 与重试。用受控负载测,不从节点图推断时延。
把三个 worker 合并为单 Agent 跑同 fixture,列出结果、tool calls、token、policy 和恢复差异。然后只拆出 Safety Verifier;如果这是唯一带来可靠性收益的分离,生产就采用两层而不是八角色。
一个 task 内各 worker 使用相同 protocol/patient snapshot 和 contract;模型可不同,但 route 记录。迟到 worker 若基于旧 state,merge 检查 base version,不能把旧 Evidence 覆盖新结果。协议更新不向进行中 worker 广播,除非 orchestrator 取消并重开版本。
为每个 role 写 RACI:谁负责输出、谁批准、咨询谁、通知谁。Protocol Agent 对草案负责,研究人员批准协议;Safety Verifier 对检查结果负责但不作临床签署;Orchestrator 只对流程。角色名若无法对应 owner、权限和 SLO,就只是 prompt 人设。
按 DAG 查看每个 subtask 的 input/output hash、tool ledger、预算和 error;可在同 snapshot 单独重放 worker。比较单/多 Agent 时复用相同 adapter 和 verifier。不要只读对话日志猜哪个角色“思考错了”。
拆分后的每个角色都要能说清 owner、输入、允许工具、输出和失败去向。说不清这些时,保留单 Agent 或确定性工作流通常更安全。
- 多 Agent 自我讨论不是独立验证,尤其使用同模型/同证据时。
- 若消融显示正确率、安全或恢复没有改善,应删去多 Agent 主链。
- 共享记忆可能扩大 PHI 泄露范围,应按任务和患者隔离。
- 并行外部工具仍受限流与数据库负载约束。
资料与延伸阅读
Section titled “资料与延伸阅读”以下参考资料帮助分别理解编排机制、工具边界和多模态 Agent 评测环境。它们不是“多 Agent 一定更好”的证据。