逐条资格匹配:unknown 是一等公民
最容易被误写成“符合”的,不是一个明显的阳性病例,而是证据不完整的病例:报告没回来、日期超出窗口,或两份来源说法相反。这时给一个干脆的“是/否”,看起来省事,却会把需要人工处理的工作藏掉。
医疗候选筛选更合理的输出是四态:met、not_met、unknown、conflict。unknown 表示缺少决定性证据;conflict 表示存在相互不一致且尚未解决的证据。它们不是低置信度的同义词,而是会触发不同下一步的工作状态。
来龙去脉与痛点
Section titled “来龙去脉与痛点”TrialGPT Matching 对每条入排标准给出匹配和解释,再聚合成试验排序,这比一次性判断整项试验更可审计。S30 但实际 EHR 中“未记录”经常被误当“没有”,旧结果可能被新结果推翻,否定句可能只在一个 encounter 内成立。
二分类准确率会掩盖危险行为:把所有模糊例子判“不符合”也许准确率不低,却错失候选;全部判“符合”则增加协调员负担。需要分别测四态混淆、unknown 识别和人工升级质量。
证据优先求值器
Section titled “证据优先求值器”每个 criterion 先声明所需证据类型、有效时间窗、允许单位和求值算子。求值顺序:
- 查询限定患者与截止时间的证据。
- 排除无效、过期或来源不满足的记录。
- 无有效证据 →
unknown。 - 有效证据内部矛盾且规则不能消解 →
conflict。 - 应用确定性规则;无法表达部分交给模型,但输出仍需引用 evidence ids。
- 独立 verifier 检查引用、时间窗和逻辑。
聚合时不能简单多数表决。任一关键 exclusion met 可阻断;关键 inclusion unknown 应进入补充信息队列,不应伪装为满足。
读图:冲突应当留在工作单上,而不是被平均掉
Section titled “读图:冲突应当留在工作单上,而不是被平均掉”下面的界面来自合成研究沙箱。Stage IV disease 显示为 Conflict,同时列出三条来源证据。正确的下一步是人工判读差异,而不是让系统取“最新一条”或把三条记录投票平均。
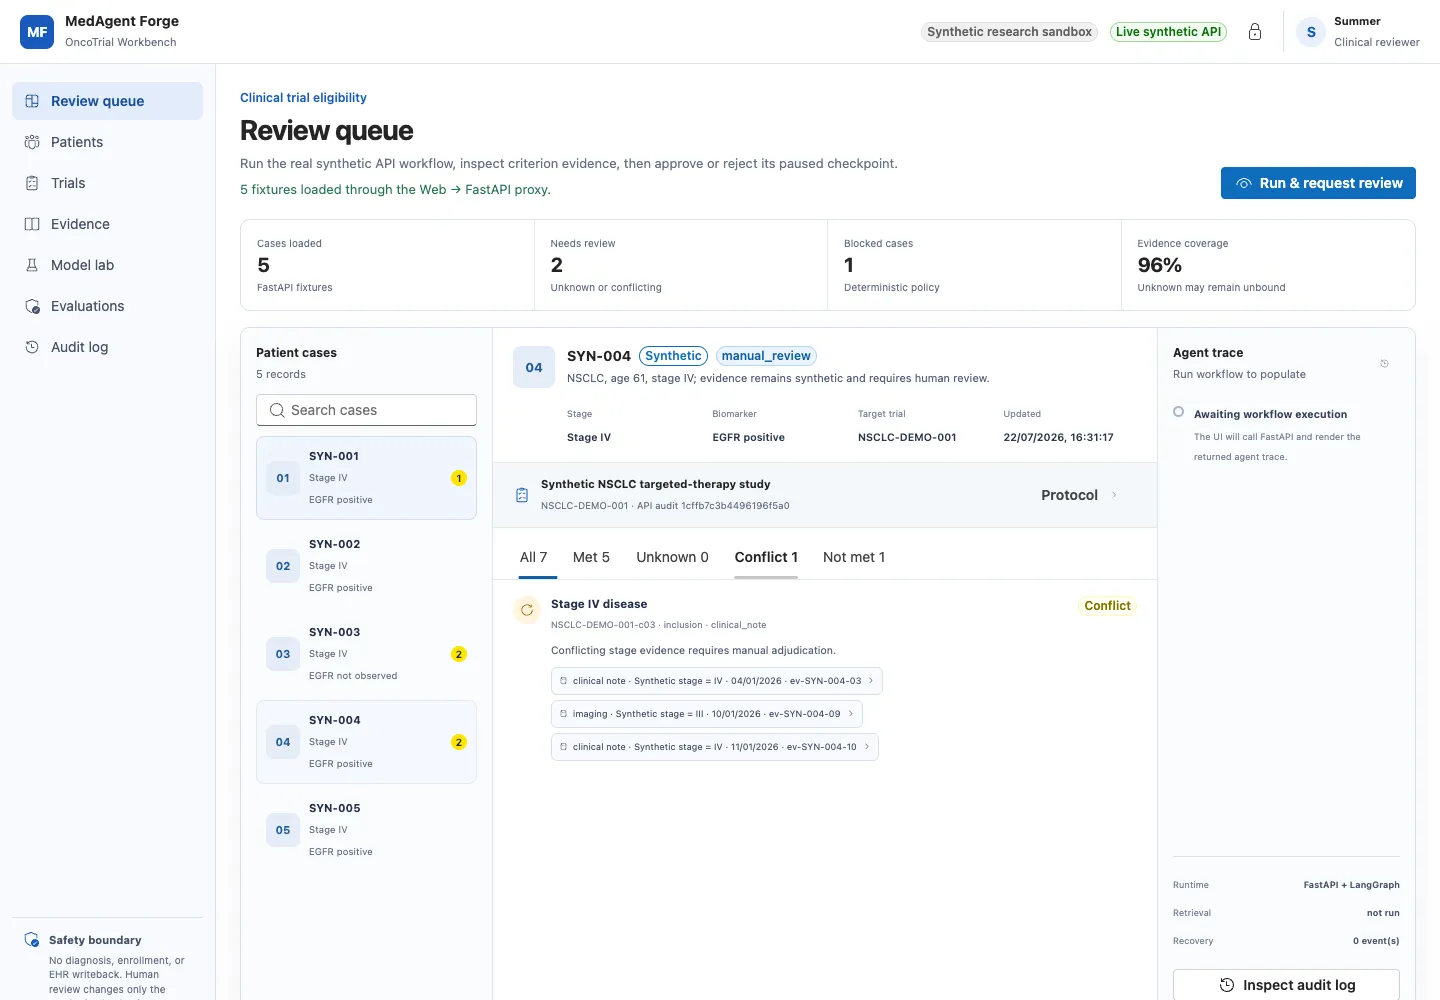
图中显示的是受控合成病例和界面行为,不构成患者判断或临床有效性证据。
| 方案 | 透明度 | 风险 |
|---|---|---|
| 单次 LLM 是/否 | 低 | 缺失时猜测,难定位 |
| 规则引擎 | 高 | 难覆盖自由文本与复杂例外 |
| TrialGPT criterion matching | 中高 | 需增加本地证据合同 S30 |
| 规则 + 模型 + verifier | 高 | 工程复杂,但可分层测试 |
python3 labs/run_lab.py --lab 11实验对年龄、EGFR 和既往治疗三条标准运行四态求值器。病例缺 EGFR 时必须为 unknown;同一时间窗内有阳性和阴性时必须为 conflict。改变聚合器让 unknown 当 false,观察工作单信息如何被错误压扁。
建议先记录每条 criterion 的四态和 evidence id;再仅把缺失的 EGFR 输入给求值器;最后把聚合器改成把 unknown 当 false。最后一步的“结果更整齐”正是本章要避免的失败模式。
三条标准,三种不同求值器
Section titled “三条标准,三种不同求值器”年龄条件是确定性数值规则:读取患者出生信息与参照日期,处理日期精度后比较。EGFR 条件需要基因 Evidence:检查变异、assay、specimen 和时间,可能产生 conflict。既往治疗条件需要 Medication/Procedure/病历抽取,涉及否定和例外,模型可以提出结构化判断,但 verifier 必须核对引用与时间。
这说明“criterion matching model”不应是单一黑盒。CriterionRouter 根据 operator 和 Evidence requirement 选择 numeric、temporal、set-membership、logical 或 model-assisted evaluator。每个 evaluator 返回同一 CriterionAssessment 合同。确定性规则的结果同样进入 verifier,避免单位或参照时间错误。
假设年龄 met、EGFR unknown、未发现明确排除治疗。trial-level 不能写“符合 2/3”。关键 inclusion unknown 意味着 needs_more_information;协调员看到缺的是哪项检测和最后有效日期。若一条 exclusion 确定 met,则状态可以是 screening_excluded,但仍保留其他 criteria 的证据供审计。
unknown 的原因要可运营
Section titled “unknown 的原因要可运营”unknown 至少分为 missing_source、source_unavailable、mapping_unknown、outside_valid_window、protocol_ambiguous、model_abstained。这些 reason code 对下一步不同:缺实验室可请求补充,FHIR 暂不可用应重试,协议歧义交给研究团队,模型 abstain 可交另一规则/人工。不要把 reason 变成新的资格状态;资格四态保持稳定,工作流另存 next action。
conflict 也需要来源级表示。可能是同一资源版本冲突、不同模态冲突、不同时间状态变化,或术语映射冲突。规则可以解决“amended 覆盖 final”这类明确版本关系,但不能把所有冲突都用“最新优先”消掉。
解释怎样做到短而可核验
Section titled “解释怎样做到短而可核验”面向协调员的 rationale 采用模板化核心:结论、标准关键条件、证据事实与时间、缺口/冲突。模型可润色,但 evidence ids 和数值由程序插入。不要保存模型长思维链;它不可验证、可能含敏感内容。审计保存输入合同、行动、简短理由和 verifier。
引用验证分三步:存在性(id 真实)、适用性(同 patient/version/time)、支持性(事实能支撑结论)。前两步确定性完成,第三步规则优先、模型辅助。TrialGPT 的 criterion-level explanation 提供重要思路,S30 本项目进一步让 explanation 绑定结构化 Evidence。
聚合器与人工覆盖
Section titled “聚合器与人工覆盖”聚合器不是简单平均。Protocol Tree 定义 AND/OR/NOT,关键状态沿逻辑传播:AND 中任何 not_met 使整体 not_met;没有 not_met 但至少一个 conflict 则 conflict;再有 unknown 则 unknown;全部 met 才 met。exclusion 条件的语义先转换清楚,避免双重否定。
人工覆盖产生新的 HumanDecision,包含 reviewer、时间、原 assessment、选择、理由和额外 evidence;不会改写机器记录。若某类覆盖频繁发生,回到 parser/evaluator/数据问题,不能把人审当无限兜底。
报告四态混淆矩阵、每态 precision/recall、关键 exclusion 漏判、unknown resolution、citation support 和 calibration。trial-level 还看候选召回与人工负担。不能只用 accuracy,也不能把 unknown 样本从测试集删掉,因为缺失就是部署现实的一部分。
章末练习:为 no prior targeted therapy within 6 months 构造 met、not_met、unknown、conflict 四例,写清参照日期和 Evidence。随后尝试用一个布尔字段表达,你会看到缺失与冲突被压扁;这正是四态合同存在的理由。
- 四态仍是工程抽象,不能覆盖所有临床不确定性。
- “最新结果优先”不是通用规则;需按 assay、标本和协议定义。
- verifier 若和主模型共享同一盲点,不能称为独立证据。
- 人工覆盖机器判断必须记录理由,不能修改原始轨迹。
完整的来源类型、用途与边界见教材来源注册表。
资料与延伸阅读
Section titled “资料与延伸阅读”- TrialGPT 论文 与 作者代码:了解 criterion 级理由和分层匹配的研究思路。
- MedAgentBench:关注执行环境如何把任务成功与轨迹约束一起测试。
- NIST AI Risk Management Framework:对照本章的未知、冲突、人工升级和发布门,建立可追责的风险记录。